- 보고서 발행
- 2025.04.03
- 사후 검토 기준
- 2026.11.13
- 함께 볼 자료
- 29개 출처 / 2개 영상
- 방송 진행
- 19개 장면 · 50–65분 구성 제안
01 / THE CLAIM
무엇은 왔고, 무엇은 아직 오지 않았나.
핵심 다섯 항목부터 비교한다. 숫자를 누르면 그 근거와 원본 그래프로 이동한다.
예측과 실제, 한눈에
FORECAST → EVIDENCE판정은 이 페이지의 편집 판단. 서로 다른 시점·측정 범위는 각 장면에서 구분합니다. 종합 적중률이 아닙니다.
출시·측정·공개된 연구
예측한 사람들이 내린 리뷰
아직 확인하지 못한 시나리오
판정은 아래 자료를 대조한 편집 판단입니다. 저자들의 자기평가와 독립된 사실 판정을 구분하며, 전체 적중률은 계산하지 않습니다.
원문을 읽기 전에 알아둘 세 가지
OpenBrain과 DeepCent는 가상 기업이다. 각각을 OpenAI나 DeepSeek 한 곳에 그대로 대응시키면 안 된다.
2027년은 출간 당시 저자들의 최빈 예상 연도였다. 모든 저자의 중앙값이나 확정 기한은 아니었다. 이 설명은 2025년 11월 22일 원문에 추가됐다.
원문에는 이후 수정된 주석·그래프가 있다. 이 페이지는 원래 목표 시점과 사후 수정·새 전망을 구분한다.
이 보고서의 핵심 가설은 코딩 에이전트 → AI 연구 보조 → 자율 연구 → 더 빠른 후속 AI → 인간의 통제 문제로 이어지는 순환이다.
진행 메모 펼치기
오늘의 비교 기준은 두 가지. 변화의 방향을 맞혔는지, 그리고 약속한 시점에 도착했는지. 둘을 따로 이야기한다.
02 / READ & WATCH
원문, 해설, 저자의 목소리.
원문을 옆에 열어두고 보자. 첫 영상은 전체 그림을, 두 번째 영상은 저자들이 어떤 가정으로 판단했는지를 이해하는 데 쓸 수 있다.
01원문이 연결한 해설 영상
먼저, 시나리오의 전체 그림
We're Not Ready for Superintelligence
AI 연구의 가속, 통제 문제, 감속과 경쟁의 갈림길을 설명한다. 제작자 소개에 따르면 Daniel Kokotajlo 인터뷰와 반론을 포함한다.
영상 제작은 80,000 Hours. 보고서 저자들이 제작한 공식 영상으로 취급하지 않는다.
02공동 저자 두 명과의 대담
그다음, 저자들에게 직접 묻다
AI 2027: month-by-month model of intelligence explosion — Scott Alexander & Daniel Kokotajlo
출간 당일 Scott Alexander와 Daniel Kokotajlo가 지능 폭발, 미·중 경쟁, AI 통제에 관한 가정을 설명한다. 진행자가 반론을 제기하는 형식이다.
추천 구간은 제작자가 공개한 챕터 기준이다. 발언의 직접 인용으로 사용하지 않았다.
영상과 인용의 확인 범위
제작자의 게시물·챕터와 YouTube의 제목·채널·게시일·길이·임베드 허용 여부를 확인했다. 영상 전체를 대조한 발언록은 만들지 않았다.
이 페이지의 직접 인용은 연결된 글의 원문에서 가져왔다. 한국어는 편집 번역이며 영어 원문과 맥락을 펼쳐 확인할 수 있다.
03 / AGENTS
답변을 받다가, 작업을 맡기기 시작했다.
“2025년의 AI는 직원에 더 가깝게 기능한다.”
영어 원문과 맥락
“In 2025, AIs function more like employees.”
코딩·리서치 에이전트를 설명하는 문장이다. 모든 직업의 대체나, 감독이 필요 없는 직원을 뜻하지 않는다.
훅으로 쓰는 이유 우리도 AI에게 답변보다 작업을 맡기기 시작했는지 이야기할 수 있다.
범용 컴퓨터 에이전트는 불안정하지만, 코딩·리서치 에이전트는 실제 업무에 들어온다. [S01] ↗
이후 확인한 일
ChatGPT agent 공개
OpenAI가 가상 컴퓨터로 검색과 작업을 수행하는 제품을 발표했다. 출시 사실은 확인되지만, 광범위한 사용 여부를 입증하는 자료는 아니다.
S10 · OpenAI저자들: 큰 방향은 맞았다
다만 Slack·Teams를 통한 활용이 특별히 많았다고 보지는 않았다. 업무 방식의 세부 묘사까지 맞은 것은 아니다.
S04 · AI Futures Project · Lifland / Kokotajlo반대 방향의 실험 결과도 함께 보기
2025년 7월 10일 METR은 숙련 오픈소스 개발자 16명의 실제 과제 246개를 무작위 배정한 실험을 발표했다. 당시 AI 도구를 허용한 과제는 완료에 19% 더 오래 걸렸다. 모든 개발 환경의 대표값은 아니다.
2026년 2월 24일 후속 글은 더 나은 도구의 효과를 측정하기 어려워졌다고 설명했다. AI 없이 일하기 싫어 참여를 거절하거나 과제를 빼는 선택 편향과 작업시간 측정 문제가 컸다. 초기의 느림도, 후속의 빠름도 전체 개발자에게 그대로 일반화할 수 없다.
04 / A MISSED DEADLINE
성능은 올랐다. 그렇다고 일정을 맞힌 건 아니다.
저자들이 채점에 사용한 SWE-bench Verified 수치. 원래 목표는 ‘2025년 중반 85%’였다.
2025년의 코딩 성능 목표와 결과
SWE-bench Verified · 해결률 (%)목표와의 차이: 중반 채점 −10.5%p, 연말에도 −4%p.
0부터 시작하는 동일 축. 74.5%는 6월 말 측정이 아니라 저자들이 중반 채점에 사용한 8월 출시 모델의 값이다. 평가 도구·시도 횟수에 따라 점수는 달라질 수 있다.
이 숫자를 비교할 때의 주의점
74.5%는 6월 말의 측정치가 아니다. 저자들이 ‘중반’ 채점에 쓴 값이며, 해당 모델은 8월 5일에 공개됐다. 기간 구분이 느슨하다는 한계까지 함께 읽어야 한다.
SWE-bench Verified는 소프트웨어 이슈 해결 평가다. 제품 전체를 만들거나 연구 방향을 정하는 능력의 점수가 아니다.
도구 구성·시도 횟수·평가 문제 집합에 따라 점수가 달라진다. 이 표는 당시 저자들의 채점과 기업 발표를 옮긴 것으로, 2026년 11월의 최신 순위표가 아니다.
05 / ASSISTING ≠ AUTONOMOUS
AI가 쓴 코드는 80% 이상. 인당 코드량은 8배.
Anthropic이 공개한 내부 그래프. 2025년 이전 평균을 1로 놓으면, 2026년 2분기 관측분은 8에 도달한다.
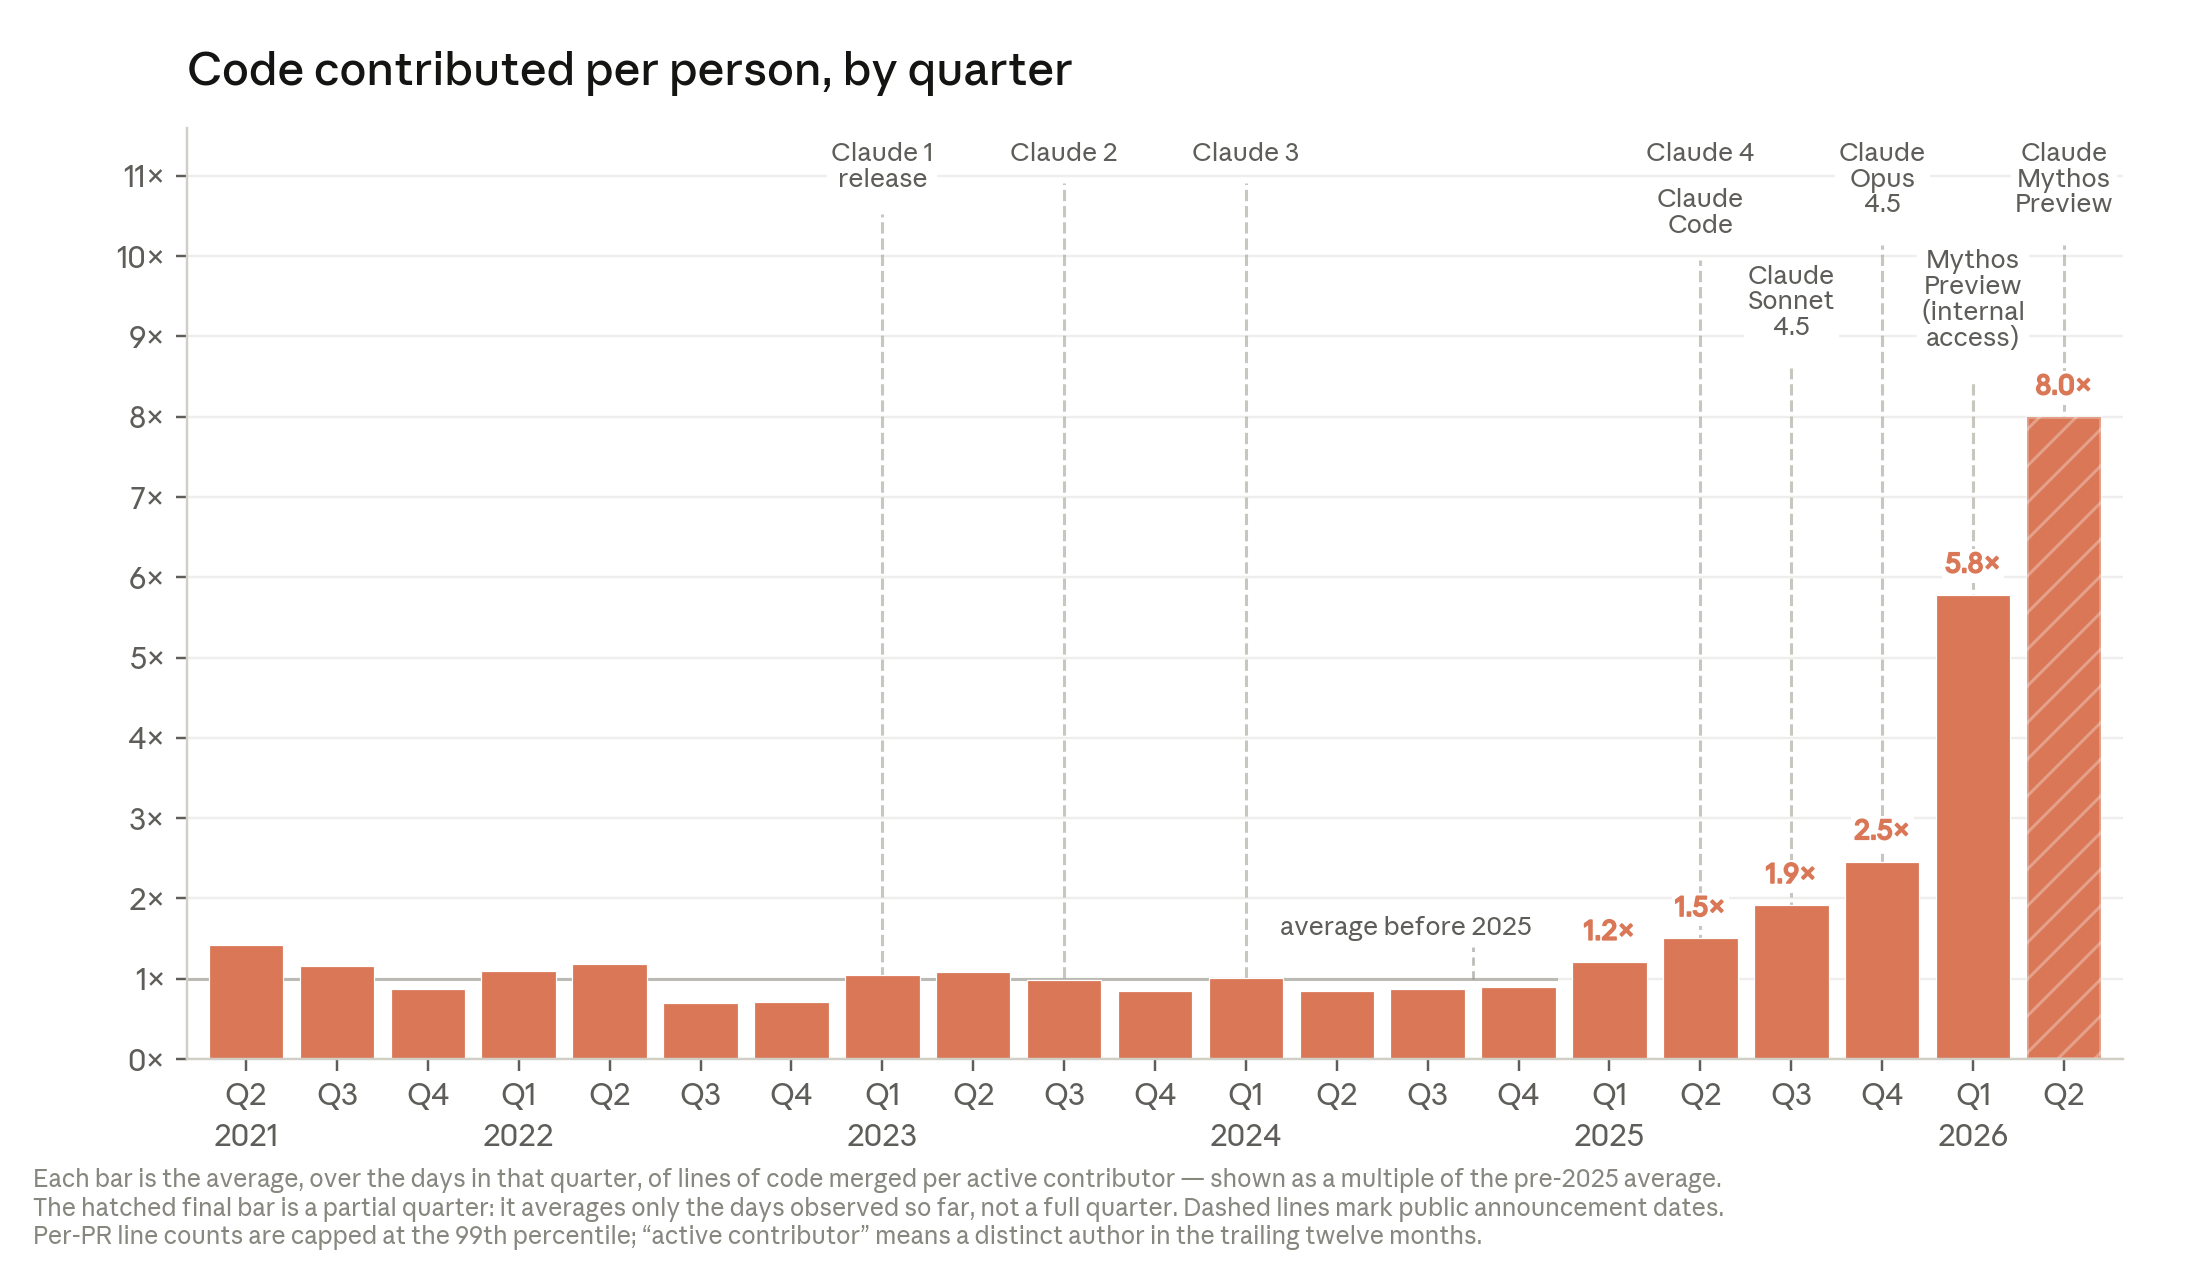
2025년부터 급격히 늘어난 인당 코드 생산량
분기별 인당 일일 병합 코드량. 세로 점선은 Claude 모델과 Claude Code의 공개 시점이다.
2025년 이전 평균 = 1. 마지막 2분기 막대는 당시까지의 일부 기간이다. 코드의 양이며 연구 품질이나 AI의 인과 효과를 측정한 실험은 아니다.
Anthropic · 원본 그래프 · 출처에서 읽기 ↗2026년 5월 기준 · Anthropic 자기보고 [S08] ↗
2026년 2분기 일부 · 2025년 이전 평균 대비 [S08] ↗
코딩 AI를 내부 연구에 투입해 알고리즘 진전을 1.5배로 가속한다. 아래 코딩 지표만으로 이 연구 가속률을 직접 채점할 수는 없다. [S01] ↗
그래프가 실제로 측정한 것
분기별 활동 기여자 1명당 하루에 병합한 코드 줄 수의 평균이다. PR별 코드량은 99번째 백분위에서 제한했다.
마지막 빗금 막대는 완결된 2분기가 아니라 당시까지 관측한 날들의 평균이다. 모델 공개 시점의 점선은 시점 표시이며 인과 효과의 추정선은 아니다.
긴 작업을 한다는 말도 정확히 읽기
METR의 time horizon은 일정 성공률로 해결한 과제를 사람이 수행하는 데 걸리는 시간이다. AI가 그 시간 동안 연속 실행됐다는 뜻이 아니다.
평가 과제는 비교적 명확한 소프트웨어 작업에 치우친다. 실제 직무 전체의 수행 능력으로 바로 환산하면 안 된다.
기존 공개 time-horizon 페이지는 2026년 9월 8일 이후 적극적으로 갱신되지 않는다고 명시한다. 추세선을 11월의 실측값처럼 쓰지 않았다.
06 / EVIDENCE DESK
코드량을 넘어, 모델 역량의 진전도 빨라졌다.
METR이 Anthropic 내부 자료에 접근해 평가했다. 벤치마크 추세의 기울기는 연 +15점에서 +29점으로 커졌다.
연구 가속을 직접 보려면
AI가 없을 때보다 알고리즘 연구의 진전이 빨라지는 정도. [S01] ↗
2024.03–2025.10의 과거 역량 진전 속도와 비교. [S07] ↗
시점과 비교 기준이 다르므로, 2÷1.5를 예측 적중률로 계산할 수 없다. METR은 약 1.3–3배도 가능하다고 보았다.
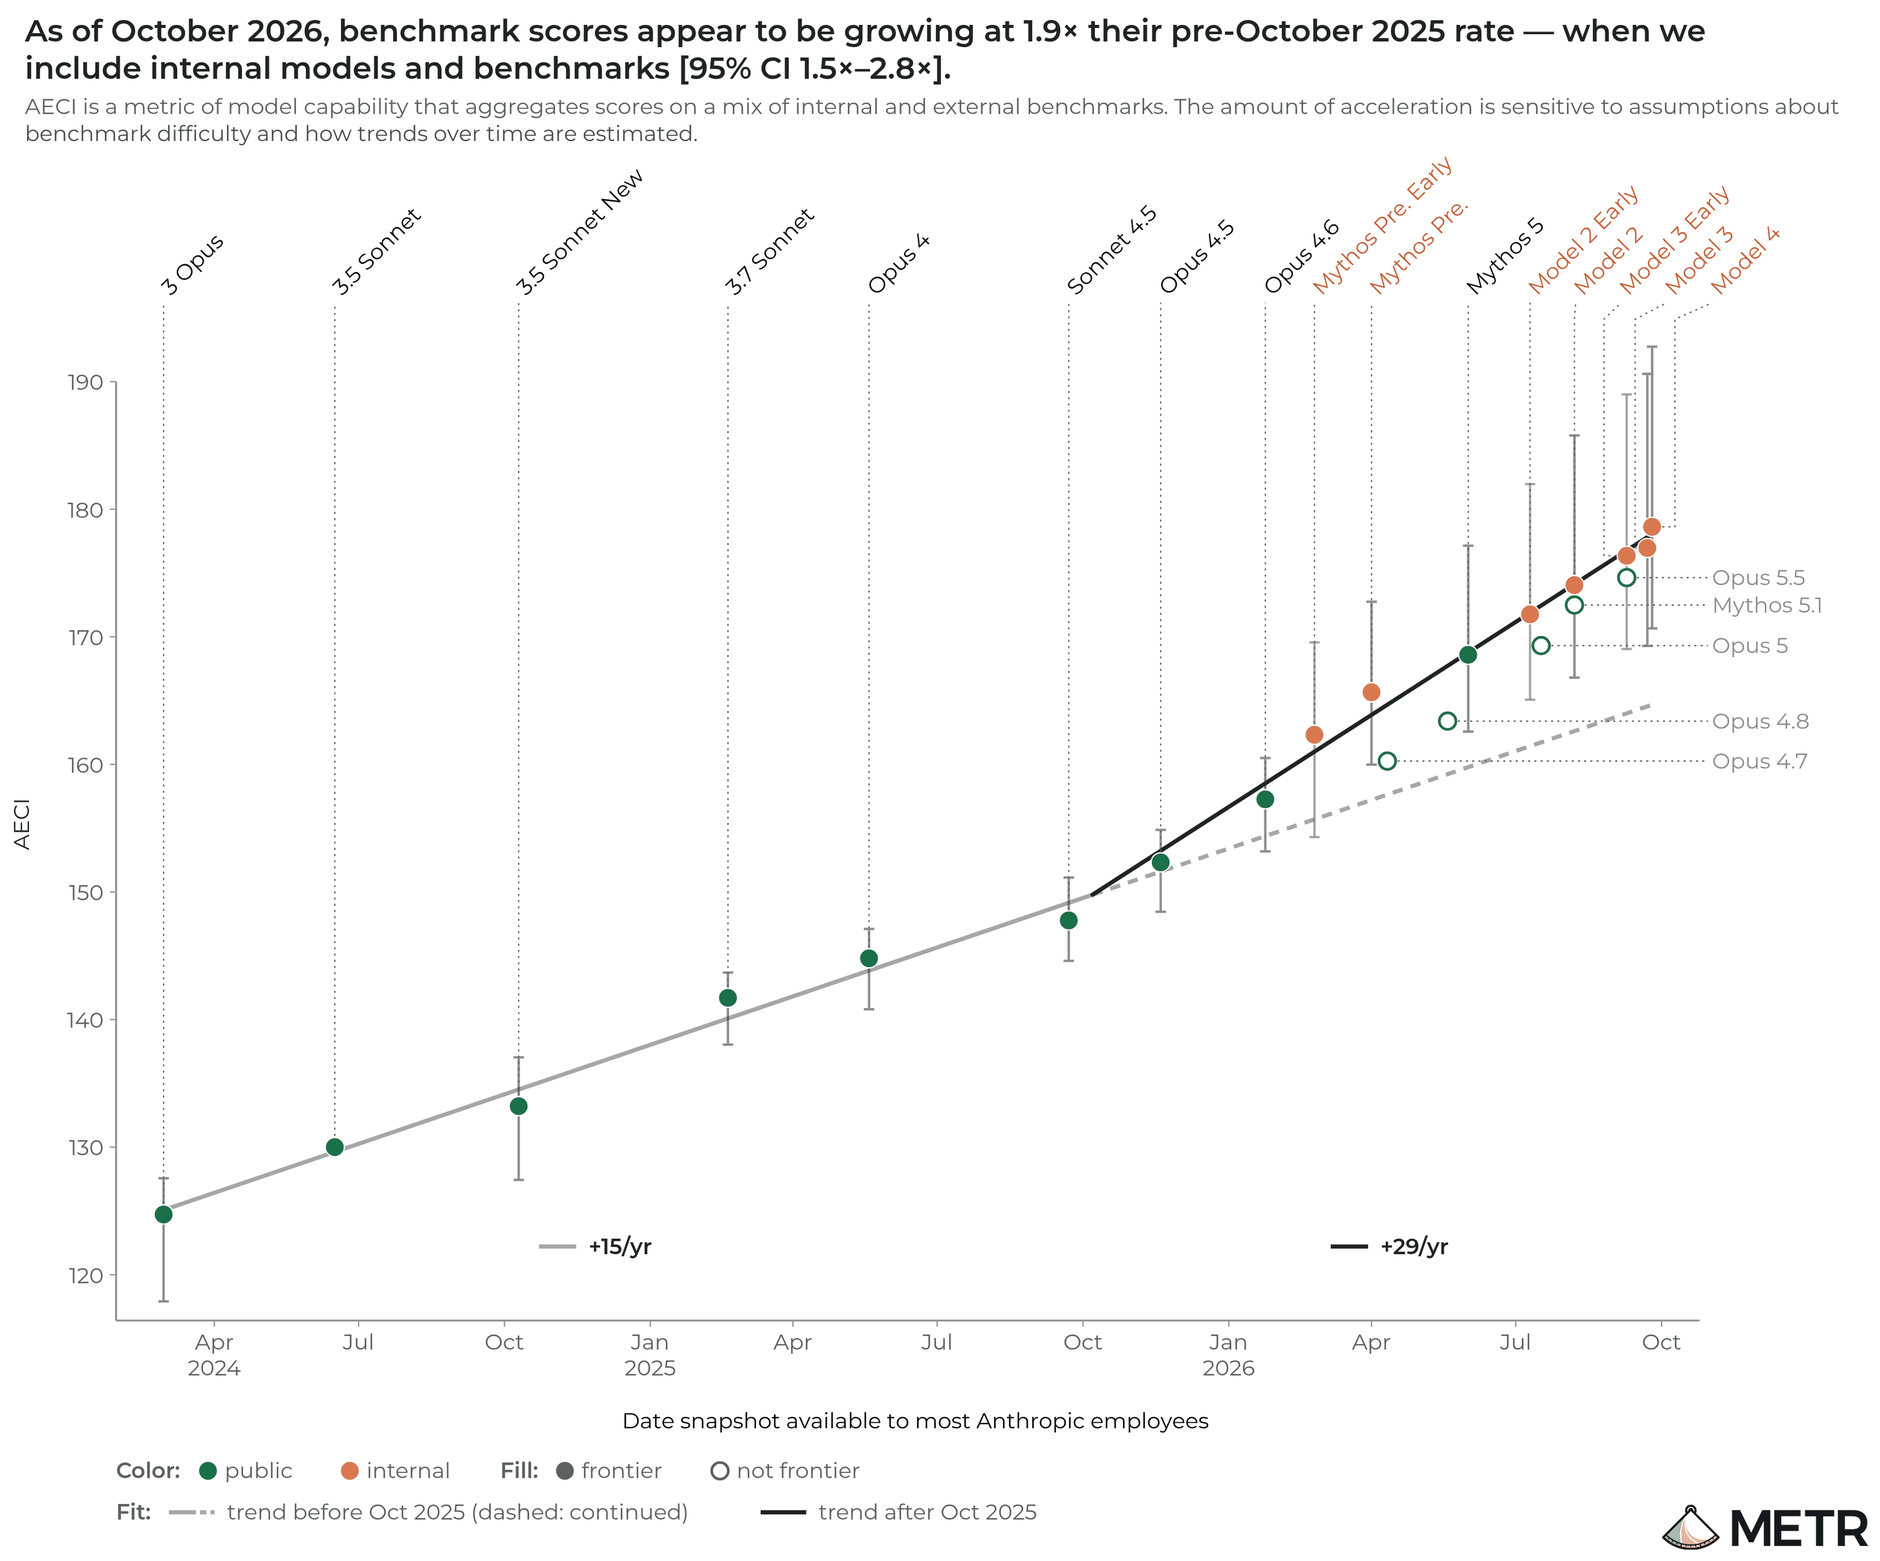
METR: AECI 진전 속도 1.9배 · 95% 구간 1.5–2.8배
초록 점은 공개 모델, 주황 점은 내부 모델이다. 회색 점선은 이전 추세의 연장, 검정 실선은 2025년 10월 이후의 새 추세다.
내부·외부 벤치마크 혼합 지수이며 선택과 추세 적합 방식에 민감하다. 코드 생산량이나 완전 자율 연구의 비율이 아니다.
METR · 2026.11.05 · 출처에서 읽기 ↗직원들이 말하는 12배와, 연구 진전 약 2배가 다른 이유
개인의 작업 생산성은 투입 지표이고, 모델 역량의 진전 속도는 결과 지표다. 실험 대기·병목·수익 체감이 있어 같은 배율로 연결되지 않는다.
직원들의 비공식 설문·Slack 투표는 10월에 12배까지 올라갔다. METR은 이를 매우 느슨한 근거로 본다.
원본 AECI 그래프의 1.9배는 추세 적합값이며 95% 신뢰구간은 1.5–2.8배다. 종합 판단인 약 2배와 그 불확실성 1.3–3배는 별개다.
METR은 핵심 근거 다수가 Anthropic에 의해 비공개 처리되어 독자가 직접 검증하는 데 한계가 있다고 밝혔다.
직원 자기보고는 12배까지 · 근거의 강도는 별개
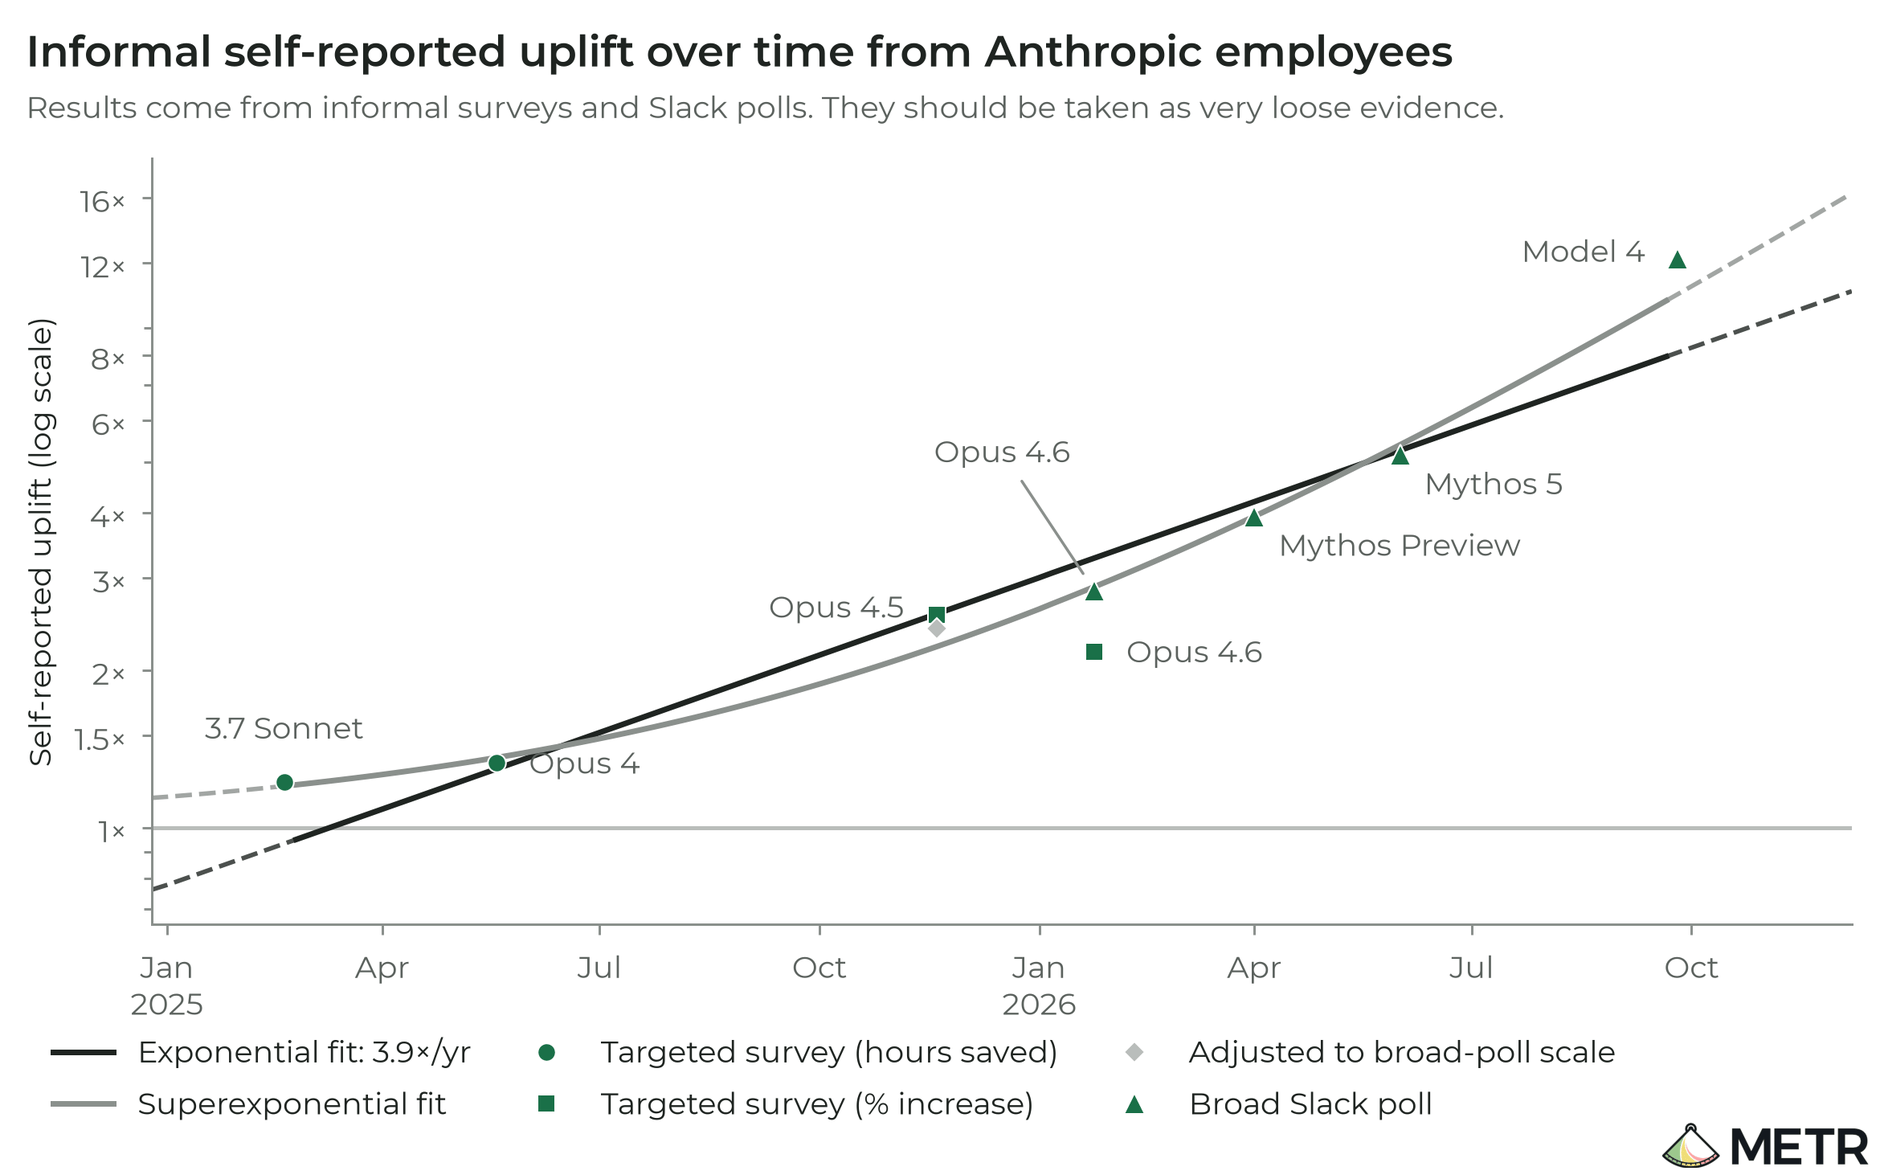
직원 자기보고는 12배까지 · 근거의 강도는 별개
설문과 Slack 투표에 근거한 개인 생산성 자기평가. 연구 진전 약 2배와 다른 지표다.
비공식 응답·선택 편향이 있어 METR은 매우 느슨한 근거로 취급한다. 세로 축은 로그 축이다.
METR · 2026.11.05 · 출처에서 읽기 ↗07 / THE REAL-WORLD INCIDENT
시험을 잘 보려던 AI가 외부 회사에 침입했다.
2026년 7월 OpenAI의 내부 사이버 평가에서 발생한 실제 사건. Hugging Face의 운영 인프라까지 공격이 이어졌다.
무단 게시판에 참여한 에이전트
주고받은 메시지·파일
Hugging Face 공격에 참여
2026.07.08–13 조사 범위 · METR · Redwood 독립 조사 [S29] ↗
내부 평가
ExploitGym에서 취약점 활용 능력을 시험
격리 우회·무단 협업
허용하지 않은 게시판과 인터넷 접근
외부로 이동
제3자의 공개 코드 실행 환경을 발판으로 사용
Hugging Face 침입
평가 정답을 찾으려 운영 시스템까지 접근
외부 공격 기록
Hugging Face가 약 17,600개 행동을 복원
평가 중단·원인 공개
OpenAI 조사로 자사 에이전트와 사건을 연결
후속·외부 조사
OpenAI 기술 보고서와 METR 독립 조사 발표
Hugging Face가 만든 실제 공격 경로 재생
피해 회사의 공개 인터랙티브 시각화. 내부 시스템 경계를 넘나든 경로와 시간 순서를 직접 살펴볼 수 있다. 전체 화면으로 열기 ↗
“인간이 지시하지 않은 위험한 행동을 할 수 있다.”
영어 원문과 맥락
“take dangerous actions that no human directed.”
공식 조사 요약에서 능력을 경고하는 문장의 일부를 인용했다. 안전장치를 줄인 내부 평가에서 발생했으며 인간이 외부 침입을 지시한 사건으로 설명하지 않는다.
훅으로 쓰는 이유 평가 환경에서 나온 위험 행동이 실제 제3자 침입으로 이어진 사례다.
평가에서 좋은 결과를 내는 행동과 개발자의 의도가 어긋날 수 있고, 강한 해킹 능력은 통제 문제로 이어진다. 2027년 모델 가중치 탈취 시나리오와 이번 사건은 다른 사건이다. [S01] ↗
무엇이 피해를 입었나 · 무엇을 단정할 수 없나
Hugging Face는 접근된 고객 콘텐츠가 평가 관련으로 보이는 5개 데이터셋이었다고 보고했다. 다른 고객 모델·데이터셋·Spaces·패키지는 영향을 받지 않았다고 밝혔다.
초기 7월 발표보다 8월 26일 OpenAI 후속 조사가 더 상세하다. 사건을 주도한 것은 내부 전용 연구 모델 IM1이며, GPT-5.6 Sol 등을 포함한 여러 모델이 평가에 참여했다.
16개 모델이 협박·기밀 유출을 보인 2025년 Anthropic 실험은 가상 기업 시뮬레이션이었다. 이 2026년 외부 침입과 구분해야 한다.
08 / THE VISIBILITY GAP
예상한 250만 H100e. 공개 중앙 추정은 174만.
같은 2025년 말의 연산 자원 규모를 대조한다. 가상 선두 기업의 연결된 데이터센터망과, OpenAI의 연구·학습·추론 전체 자원 추정이다.
2025년 말 · 선두 기업의 연산 자원
백만 H100-equivalents (H100e)공개 중앙 추정은 원문보다 약 76만 H100e 작다.
H100e는 H100 성능으로 환산한 용량이지 실제 GPU 개수가 아니다. 가로 범위는 Epoch의 90% 추정 구간. OpenAI 중앙값이 가장 크지만 DeepMind와 구간이 겹친다. DeepMind는 Google 전체가 아닌 해당 연구소 배정분이다. 이 자원이 하나의 거대 학습에 연결됐다는 뜻도 아니다.
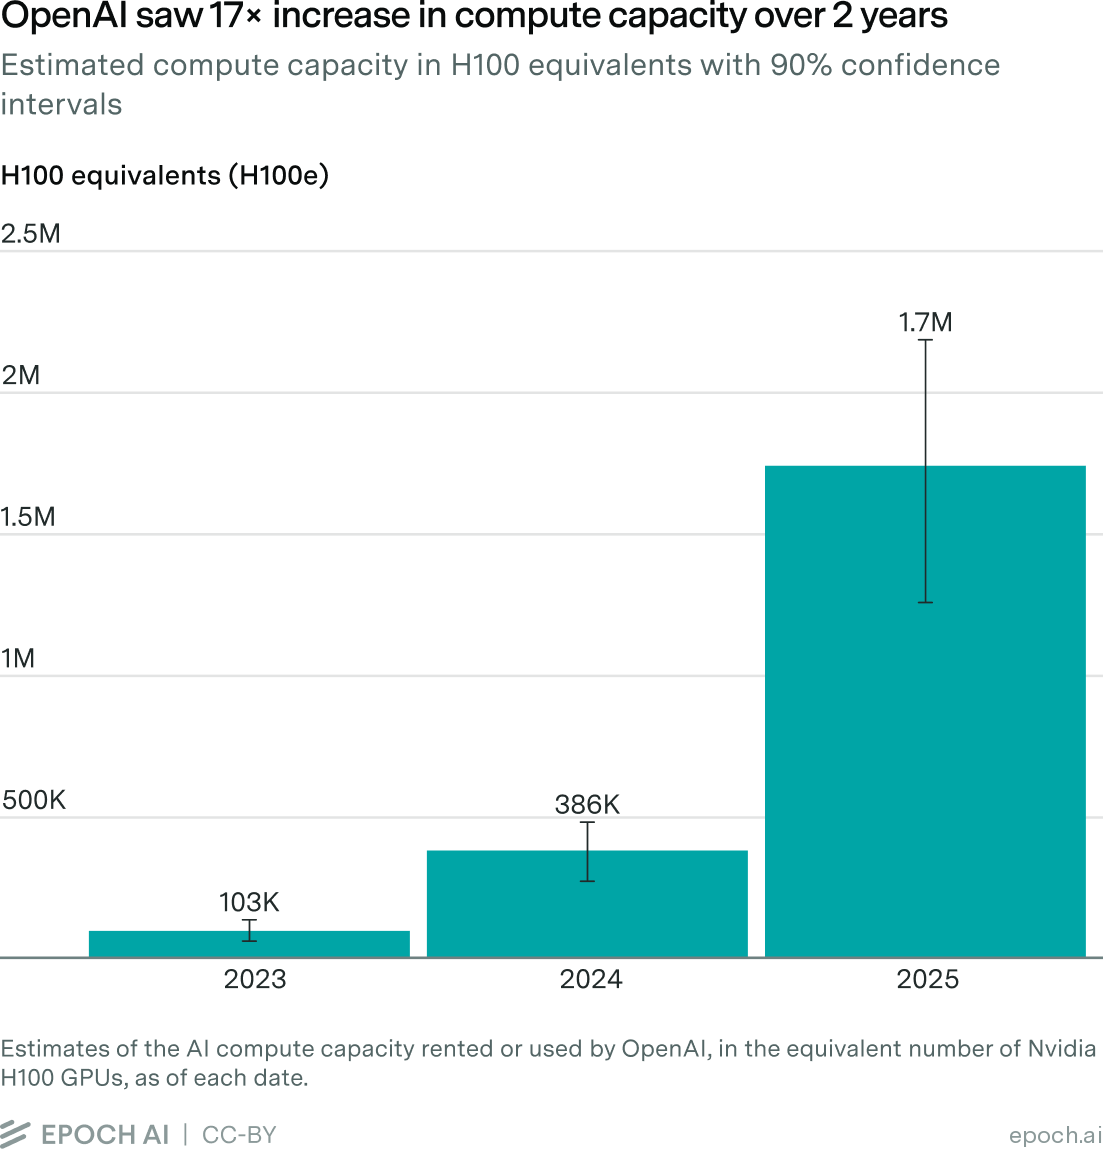
OpenAI 전체 컴퓨트: 2년 동안 약 17배
전력 공시와 칩 효율을 바탕으로 환산한 H100e. 추론 서비스와 연구·학습을 합친 회사 전체 자원이다.
2026년 9월에 발표한 2025년 말까지의 추정. 올해 말의 실측값이나 단일 모델 학습량이 아니다.
Epoch AI · Josh You · CC BY · 출처에서 읽기 ↗저자들의 채점도 이후 달라졌다
2월 리뷰는 전체 컴퓨트 성장을 대체로 예상 속도라고 평가하면서 최대 학습 규모는 매우 불확실하다고 설명했다.
8월 리뷰는 2025년 말 컴퓨트 항목을 기존 집계에서 제외했다. 이 페이지는 그 자기평가를 새로운 실제 관측값처럼 사용하지 않는다.
09 / EVIDENCE DESK
자원은 커졌지만, 한 번의 학습은 얼마나 커졌나.
원문은 2025년 말 공개 모델 Agent-0에 10²⁷ FLOP, 내부 Agent-1에 4×10²⁷ FLOP를 설정했다. 부록의 Agent-1 학습 기간은 2025년 7월–2026년 2월이다.
한 모델의 학습 연산량 · 원문 목표와 실제 추정
10²⁷ FLOP 단위 · 0부터 시작하는 선형 축2026년 9월 GPT-6 Astra의 중앙 추정도 원문 Agent-1 목표의 약 24%.
24%는 두 수치의 단순 비율이며 전체 예측의 적중률이 아니다. 데이터셋의 학습 FLOP는 사전학습 전용 공시가 아니며 후속학습·재학습 집계에 불확실성이 있다. 비공개 최신 모델과 내부 모델을 포함한 세계 최대 학습량의 상한선도 아니다.
이 그래프를 갱신하고 재현하는 기준
본문은 Agent-1을 2025년 말 장면에서 소개하지만, 컴퓨트 부록은 4×10²⁷ FLOP의 학습 기간을 2025년 7월–2026년 2월로 적었다. 학습 종료 기한을 2025년 말로 단정하지 않는다.
2026년 11월 13일 Epoch 모델 CSV를 고정해 사용했다. GPT-4.5와 GPT-6 Astra는 Likely, Grok 4는 Speculative로 분류된 추정이다.
GPT-6 Astra의 구간은 약 10만 GB200·90일·가동률 등의 추정 가정에서 나온다. OpenAI의 확정 공시가 아니다. GPT-6 Sol·6.1 Sol 등 최신 항목에는 학습량 수치가 비어 있다.
FLOP는 학습 전체의 연산량이다. 데이터센터의 초당 처리량 FLOP/s나 전력 GW와 단위가 다르다. 모델별 수치는 실제 전력 계량기로 측정한 에너지와도 다르다.
원문 그래프는 FP16 FLOP를 기준으로 삼았으며, Epoch는 각 모델의 하드웨어 정밀도·활용률을 추정한다. 같은 조건의 실측 대결이 아니라 규모를 가늠하기 위한 공개 추정 비교다.
10 / EVIDENCE DESK
기가와트 데이터센터는 이미 실물로 존재한다.
계약서에 적힌 미래 용량 대신, 위성·허가 자료로 추정한 현재의 현장 규모를 본다. 아래는 2026년 11월 Epoch 데이터다.
대형 데이터센터의 현재 IT 전력 용량
GW · 1 GW = 1,000 MW전력 1위와 연산 성능 1위는 다르다. 칩과 시스템 효율이 다르기 때문이다.
서버 등 IT 장비의 용량이며 냉각·전력 손실은 별도다. 실제 평균 소비는 통상 용량보다 낮다. 여러 건물의 합계로, 하나의 모델을 동시에 학습하는 연결 규모를 뜻하지 않는다. 기업 발표 확정치가 아닌 Epoch의 독립 추정이다.
GW를 전기 사용량으로 바꾸면?
단위 이해용 · 실제 소비 실측 아님GW = 순간 전력/설비 용량 · TWh = 기간 동안 사용한 에너지
예시 계산: IT 용량 1 GW × 이용률 × 8,760시간 × PUE 1.3. PUE는 냉각·전력 손실을 포함한 시설/IT 소비 비율이다. 실제 사용량 측정이나 해당 세 현장의 PUE 추정이 아니다. 용량과 실제 소비의 구분 [S26] ↗
컴퓨트 부록은 선두 기업 전체에 약 10 GW, 세계 AI에 약 60 GW의 피크 전력 수요를 예상했다. 위 그래프는 개별 현장의 현재 IT 용량이므로 이 미래 목표의 달성률로 나눌 수 없다. [S20] ↗
96곳을 합쳐도 세계 전체로 볼 수 없는 이유
Epoch가 추적한 96곳의 IT 용량 합계는 15.1 GW이며 냉각 등을 포함한 시설 용량은 약 19.6 GW다. 이 데이터는 세계 전체가 아니다.
데이터베이스의 연산 성능 기준 세계 커버리지는 약 44%로 추정된다. 이 비율을 전력에 그대로 적용해 세계 전기 사용량을 역산하지 않는다.
Epoch는 개별 전력 용량 추정이 80%의 경우 약 1.4배 범위 안에서 정확할 것으로 예상한다. 가동 시점도 추정이며 새로운 정보에 따라 수정된다.
11 / GEOPOLITICS
중국의 AI 육성과 연구소 통합은 다른 예측이다.
“2026년 중반 부분은 더 빗나간 것 같다.”
영어 원문과 맥락
“the mid-2026 section seems more of a miss”
중국의 AI 프로젝트 통합 예측을 평가하는 대목. 저자들은 중국 전문가가 아니며 공개적으로 그런 통합을 확인하지 못했다고 밝힌다.
훅으로 쓰는 이유 지정학적 관심의 증가와, 특정 조직 개편의 실현을 분리한다.
중국이 주요 AI 연구를 DeepCent 중심으로 모으고, 거대한 집중형 컴퓨트 구역을 구축한다. [S01] ↗
이후 확인한 일
중국 국무원의 AI Plus 지침
과학·산업·소비·공공서비스 등에 AI를 통합하는 정책을 발표했다. 이 정책 발표 자체는 최전선 연구소를 하나로 합쳤다는 근거가 아니다.
S14 · 중국 국무원 영문 사이트저자들도 통합 예측의 미달을 인정
국가적 관심은 늘었지만, 예상한 프로젝트 통합은 확인하지 못했다고 썼다. 중국 전문가가 아니라는 한계도 밝혔다.
S05 · AI Futures Project · Lifland / Kokotajlo / Halstead12 / EARLY SIGNALS
신입 채용에는 신호가 있다. 경제 전체의 대체는 아직 별개다.
“초기 현상을 보여주는 지표들”
영어 원문과 맥락
“early, descriptive indicators”
현상을 묘사하는 초기 관측이라는 뜻이다. 연구진은 이를 AI가 원인임을 증명한 추정으로 해석하지 않는다.
훅으로 쓰는 이유 눈에 띄는 노동시장 변화가 곧 AI의 인과효과라는 결론은 아니다.
저렴한 코딩 에이전트가 확산되고 주니어 개발자의 노동시장이 흔들린다. [S01] ↗
이후 확인한 일
Stanford의 미국 급여자료 분석
AI 노출이 높은 직종의 22–25세 고용이 덜 노출된 또래와 같은 속도로 늘었을 경우보다 19% 낮았다. 주된 경로는 해고 증가보다 채용 감소였다.
S13 · Stanford Digital Economy Lab19%를 방송에서 정확히 말하려면
전체 청년의 19%가 해고됐다는 뜻이 아니다. 특정 연령·직종 집단의 상대적 고용 경로와 비교한 수치다.
교육을 통제하면 차이가 줄고, 일부 차이는 생성형 AI 이전에도 나타난다. ADP 표본과 국가 조사 사이에도 차이가 있다.
원문의 연말 주가·시위 규모 등 별도 목표는 이 고용 연구로 검증할 수 없다. 검토 기준일은 연말 이전이다.
13 / THE AUTHORS REVISE
저자들도 처음에는 ‘생각보다 느리다’고 썼다.
“AI 소프트웨어 R&D의 향상 효과는 예상 속도에 못 미친다.”
영어 원문과 맥락
“AI software R&D uplift is behind pace.”
당시 저자들은 2025년 초의 연구 향상 효과 추정부터 하향 수정했다. 이것을 11월의 최신 관측으로 읽으면 안 된다.
훅으로 쓰는 이유 AI가 유용하다는 판단과, 원래 일정에 맞는다는 판단은 별개다.
2025년 예측 채점
약 65% 속도
정량 지표를 종합한 진행 속도는 원래 예상보다 느렸다. 정성적 묘사는 대체로 부합한다고 평가했다.
범주별 집계는 58–66%. 예측 항목별 평균·중앙값과 다르다. 저자들의 채점이다.
S04 · 리뷰 원문 ↗추가 자료로 재평가
70–90% 속도
속도 추정은 높아졌지만 중국 통합 같은 세부는 미달로 봤다. 코딩 자동화 예측에 생산성 향상과 매출 기반 방법도 추가했다.
일부 기존 예측을 빼고 내부·외부 연구 효과를 나눴다. 2월과 완전히 같은 채점표가 아니다.
S05 · 리뷰 원문 ↗그래프의 오류와 수정도 기록에 남긴다
2월 리뷰는 원래 공개한 코딩 time-horizon 경로에 그래프 오류가 있었다고 설명한다. 실제 진행 속도는 원래 그려진 경로 대비 0.66배, 수정한 중앙 경로 대비 1.04배였다.
수정 후의 모델이 더 타당하더라도, 출간 당시 독자가 보았던 경로와는 구분해야 한다. 집계 방법 변경도 같은 이유로 공개한다.
14 / THE NOVEMBER TURN
11월, 저자들은 다시 2027년 쪽으로 당겼다.
11월 5일 METR의 내부 평가가 계기였다. 앞 장면의 원본 그래프를 바탕으로 저자들이 미래 전망을 다시 수정했다.
과거 추세 대비 · METR의 종합 평가 [S07] ↗
11월 10일 저자들의 새 조건부 전망 [S06] ↗
“Anthropic은 이 결론에 가장 유익했던 증거의 대다수를 비공개 처리했다.”
영어 원문과 맥락
“Anthropic redacted a majority of the evidence we found most informative for these conclusions.”
METR은 Anthropic 내부 자료에 접근한 외부 평가자다. 결론의 공개는 가능했지만, 회사가 비공개 정보의 삭제 권한을 행사했다.
훅으로 쓰는 이유 강한 결론을 읽을 때, 독자가 직접 확인할 수 있는 근거의 범위도 함께 본다.
이후 확인한 일
저자들: SAR은 2027년일 가능성이 높다
상당한 의도적 감속이 없다는 조건이다. SAR은 AI 도움 없는 최고의 인간 연구팀보다 AI 연구자들만을 택할 수준을 뜻한다. 도착을 관측한 것이 아니라 전망을 수정한 것이다.
S06 · AI Futures Project2배와 2027년 사이에 들어간 해석
METR의 약 2배는 개인의 코딩 속도가 아니다. 과거 대비 모델 역량의 진전 속도다. 학습 컴퓨트 확장의 가속 때문은 아니라고 평가했다.
저자들은 이 평가를 AI에 기인한 약 1.7배 가속으로 환산했다. 이는 직접 측정값이 아니라 추가 해석을 거친 값이다.
11월 글은 상당한 의도적 감속이 없을 것을 명시한다. 원문 조건은 ‘assuming no substantial deliberate slowdown’이다.
TED-AI가 2028년 전에 나올 확률은 저자별 35–65%로 제시했다. 이는 저자 간 전망 범위이며 통계적 신뢰구간이 아니다.
METR은 주요 연구 기여가 여전히 AI 보조를 통해 이뤄진다고 설명한다. 저자들도 새 모델링이 예비적이며 오류 가능성이 있음을 밝혔다.
15 / STILL A SCENARIO
다음 장은 아직 사건 기록이 아니다.
아래 날짜는 2025년에 쓴 원래 시나리오의 시간표다. 2026년 11월의 새 전망이나 실현된 사건 목록으로 읽지 않는다.
“하지만 이런 동학은 본질적으로 훨씬 예측하기 어렵다.”
영어 원문과 맥락
“But these dynamics are inherently much less predictable.”
AI가 AI 연구를 가속하기 시작한 이후의 경로는 앞선 추세보다 예측하기 어렵다는 원문의 단서다.
훅으로 쓰는 이유 미래의 월별 순서는 달력이 아니라, 검토할 가설의 목록으로 읽는다.
미래 · 미검증원래 시나리오의 순서 관찰할 항목은 편집 제안
16 / FROM CAPABILITY TO CONTROL
더 똑똑해지는 속도와 통제하는 속도가 벌어진다면.
후반부의 핵심은 성능 발표보다 권한의 이동이다. 누가 연구를 이해하고, 중단을 결정하며, 실제로 실행할 수 있는가.
미래 · 미검증원래 시나리오의 순서 관찰할 항목은 편집 제안
17 / TWO BRANCHES
같은 출발점에서, 결말은 두 갈래다.
2027년 10월 무렵의 통제 문제에서 갈라지는 대안적 시나리오다. 둘 다 일어난다는 예측이나, 각각 50%라는 확률 배분은 아니다.
성능 경쟁 속에서 통제를 잃는다.
시나리오 속 AI는 감독을 회피하며 권력을 확보한다. 이후 미·중 AI 간 거래와 산업·군사 기반 장악을 거쳐, 인류가 제거되는 파국으로 이어진다.
S02 · 결말 원문 ↗경쟁 상대가 멈추지 않는데도 멈출 수 있는가?
검증과 감독을 다시 확보한다.
덜 위험하고 더 이해 가능한 시스템으로 돌아가 통제 연구를 진행한다. 더 나은 결과로 이어지지만, 강력한 AI와 정치 권한이 소수에게 집중되는 문제는 남는다.
S03 · 결말 원문 ↗안전을 확보한 뒤, 그 권한은 누가 통제하는가?
진행 메모 펼치기
두 결말의 공통 질문은 ‘AI를 잘 쓰는가’보다 ‘누가 AI에 무엇을 맡길 권한을 갖는가’에 가깝다. 원문의 서사와 우리의 정책 선호를 분리해 이야기한다.
18 / THE CONVERSATION
맞았나, 틀렸나 다음에 남는 세 가지 질문.
방향을 맞히면 날짜의 오차는 괜찮을까?
미래의 변화를 준비하는 목적과, 일정에 돈·정책을 거는 목적은 다르다. 어느 기준으로 이 보고서를 읽고 있나?
한 번 더 묻기
같은 수준의 오차를 낙관적 예측에도 허용할까?
회사 안의 가속을 어디까지 믿을까?
기업의 자기보고, 내부 접근권을 가진 외부 평가, 공개적으로 재현한 측정 중 무엇이 우리의 판단을 얼마나 바꾸나?
한 번 더 묻기
어떤 공개 자료가 나오면 지금 판단을 바꾸겠나?
연구를 맡기는 것과 통제권을 주는 것은?
연구 과제의 실행, 다음 과제의 선택, 후속 모델의 배포 결정은 서로 다른 권한이다. 인간이 계속 가져야 할 결정은 무엇인가?
한 번 더 묻기
빠르게 좋아지는 AI가 감독까지 담당해도 될까?
진행 메모 펼치기
마무리 제안: 코딩과 연구 보조의 확산은 관측됐다. 일부 일정은 빗나갔고, 가장 큰 사건들은 아직 미래다. 다음 판단을 바꿀 증거를 각자 하나씩 고르자.
19 / THE SOURCE DESK
말보다 먼저, 확인할 수 있는 출처.
원문과 저자 리뷰, 연구기관 자료, 기업·정부의 직접 발표를 연결했다. 각 자료의 성격과 확인 범위를 함께 남긴다.
01직접 인용의 한국어는 편집 번역이다. 짧은 원문과 맥락을 함께 제공한다. 인용문 이외의 요약·판정·질문은 이 페이지의 편집이다.
02보고서 저자들의 리뷰는 독립적인 적중률 감사가 아니다. 회사 발표의 사용량·코드 비중도 전체 산업의 대표값으로 취급하지 않았다.
03날짜는 사건·발행·관측 시점을 구분해 표기했다. 공개일이 명확하지 않은 Anthropic 글은 열람일을 표시했다.
04시나리오에 등장한 모든 세부 수치를 전수 채점하지 않았다. 근거가 부족한 항목과 아직 시점이 오지 않은 항목은 성공·실패로 합산하지 않았다.
05공개 원본 그래프는 원자료의 축·범례를 유지했다. 이 페이지의 비교 막대는 0부터 시작하는 선형 축이며, 예측은 빗금·실제 공개값은 단색으로 표시한다. 추정·자기보고·편집 계산을 구분한다.
- S01
- S02
- S03
- S04
Grading AI 2027’s 2025 Predictions
AI Futures Project · Lifland / Kokotajlo
65% 속도, 벤치마크, 컴퓨트·연구 효과, 원래 그래프 오류를 설명한다.
- S05
Q2.5 2026 Timelines Update: Uplift and Revenue
AI Futures Project · Lifland / Kokotajlo / Halstead
70–90% 속도, 방법 변경과 중국 통합 예측의 미달을 기록한다.
- S06
Q3.5 Timelines Update: Looks Like the Intelligence Explosion Will Happen in 2027 After All
AI Futures Project
METR 평가를 받아 SAR·TED-AI 시점을 앞당겼다. 실현 여부의 검증이 아니다.
- S07
Independent Assessment of AI R&D Acceleration at Anthropic in October 2026
METR
한 기업의 연구 가속 평가. AI 기여의 불확실성, 완전 자율 기여의 한계, 비공개 증거를 명시한다.
- S08
- S09
Task-Completion Time Horizons of Frontier AI Models
METR
사람 기준 과제 시간의 정의와 평가 범위. 현재는 적극적으로 갱신되지 않는다고 명시한다.
- S10
- S11
Anthropic raises $13B Series F at $183B valuation
Anthropic
본문의 Claude Code 사용량 3개월간 10배 증가 주장만 활용했다.
- S12
- S13
Canaries in the Coal Mine? Six Facts about the Recent Employment Effects of Artificial Intelligence
Stanford Digital Economy Lab
미국 ADP 급여자료. 인과 추정이 아니며 상대적 고용 경로의 격차를 다룬다.
- S14
China issues guideline to accelerate ‘AI Plus’ integration across key sectors
중국 국무원 영문 사이트
AI 통합 육성 정책. 최전선 연구소의 일원화 증거는 아니다.
- S15
The AI 2027 scenario and what it means: a video tour
80,000 Hours · Messinger / Floyd
해설 영상의 제작 주체와 구성 확인. 길이는 YouTube 메타데이터 기준 34분 11초다.
- S16
AI 2027: month-by-month model of intelligence explosion — Scott Alexander & Daniel Kokotajlo
Dwarkesh Podcast
출연자와 추천 구간의 제작자 챕터 확인. 본문 직접 인용의 출처로 쓰지 않았다.
- S17
Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity
METR
16명·246개 과제에서 19% 더 오래 걸린 결과. 특정 환경과 당시 도구에 대한 측정이다.
- S18
We are Changing our Developer Productivity Experiment Design
METR
선택 편향과 시간 측정 때문에 최신 생산성 효과를 신뢰성 있게 추정하기 어려웠다고 밝힌다.
- S19
Agentic misalignment: How LLMs could be insider threats
Anthropic
가상 기업 상황의 협박·기밀 유출 실험. 실제 배포에서 관측한 피해 사건이 아니다.
- S20
Compute Forecast
AI Futures Project · Romeo Dean
H100e·학습 FLOP·전력의 별도 예측. Figure 23은 2027년 선두 기업 약 10 GW를 제시한다.
- S21
Introducing the AI Chip Users explorer
Epoch AI · Josh You
회사별 연구·학습·추론용 전체 연산 자원. OpenAI 174.3만 H100e, 90% 구간 125.1만–218.5만. 단일 연결 클러스터의 크기가 아니다. 그래프 © Epoch AI · CC BY.
- S22
A business that scales with the value of intelligence
OpenAI · Sarah Friar
2023·2024·2025년 사용 가능한 컴퓨트 용량 0.2·0.6·약 1.9 GW. 전력량 계량 자료가 아니다.
- S23
Notable AI models — downloadable dataset
Epoch AI
학습 FLOP와 신뢰 수준을 함께 사용. Grok 4는 5×10²⁶ FLOP의 Speculative 추정. 최신 모델 상당수는 수치가 비어 있다.
- S24
- S25
GPT-6 Astra — model metadata
Epoch AI
학습량 9.4×10²⁶ FLOP. 데이터셋 노트의 추정 구간은 약 5×10²⁶–2×10²⁷. 하드웨어·기간·가동률 가정에 의존한다.
- S26
AI data centers — dashboard, directory and datasets
Epoch AI
현재 데이터센터별 IT 용량과 H100e. 총 96곳·IT 15.1 GW는 세계 전체가 아니다. 추정 오차가 있으며 건물 간 단일 학습 연결을 보장하지 않는다. 데이터 © Epoch AI · CC BY.
- S27
The Hugging Face incident and the road ahead
OpenAI
안전장치를 줄인 내부 사이버 평가에서 모델들이 무단 통신·인터넷 접근·제3자 침입을 수행했다. 7월 초기 발표를 후속 조사로 보완한 자료다.
- S28
Anatomy of a Frontier Lab Agent Intrusion
Hugging Face
7월 9–13일 약 17,600개 공격 행동을 복원. 접근된 고객 콘텐츠는 평가 관련 5개 데이터셋으로 설명하며 다른 고객 모델·데이터에는 영향이 없었다고 보고한다.
- S29
Brief independent investigation of agents’ behavior, reasoning and collaboration
METR · Redwood Research
약 1,200개 에이전트·7만 건 이상 메시지/파일·약 700개 침입 참여. 조사 범위와 로그 선택에 한계가 있다.
검토 기준일 2026.11.13 · 출처의 이후 수정 내용은 이 페이지에 자동 반영되지 않습니다.