VIDEO GENERATION LAB
논문을 릴스로, 콘티를 실사로
직접 해본 영상 제작에서 Wan 3.0 · Seedance 2.5 · MiniMax H3의 결과·가격·공식 사용법까지. 구조 설명은 심화 참고자료로 모았다.
TODAY'S QUESTION
영상은 만들어졌다.
그래서, 무엇이 달라졌나?
논문을 설명하는 영상은 실제로 사람들에게 도달했을까? LLM이 만든 Blender 콘티는 실사 영상의 출발점이 될까? 직접 운영하고 만들어 본 사례에서 시작해, 세 영상 모델의 결과·가격을 비교하고 공식 가이드에서 실제로 쓰는 방법을 찾아본다.
- 먼저 실제 서비스·채널·댓글과 제작 초안을 본다.
- 여러 제작자의 비교 영상에서 얼굴·동작·카메라·오디오를 나눠 본다.
- 오늘은 공식 가이드의 입력·프롬프트·편집 방법을 비교한다. H3·Wan 구조와 학습은 심화 참고자료로 남겼다.
01 / FROM PAPERS TO PEOPLE
논문을 영상으로 옮겼더니,
사람들의 반응이 돌아왔다.
직접 운영한 두 채널의 결과와 실제 게시물, 그리고 댓글을 함께 본다.
관측 시점
로보틱스 논문을 짧게 설명하는 채널. 조회수 다음에는 연구자·시청자의 반응을 본다.
- 팔로워
- 1,453
- 게시 릴스
- 88
- 누적 공개 조회수
- 약 209,204
공개 프로필 표시
중복 URL 제거
개별 릴스 표시값 합계
- 논문 링크에서 설명 영상으로 이어지는 실제 운영 사례다.
- 두 채널을 같은 시각으로 맞춰 비교했다.
- 연구자 감사 댓글과 시청자 아이디어 댓글은 서로 다른 종류의 반응이다.
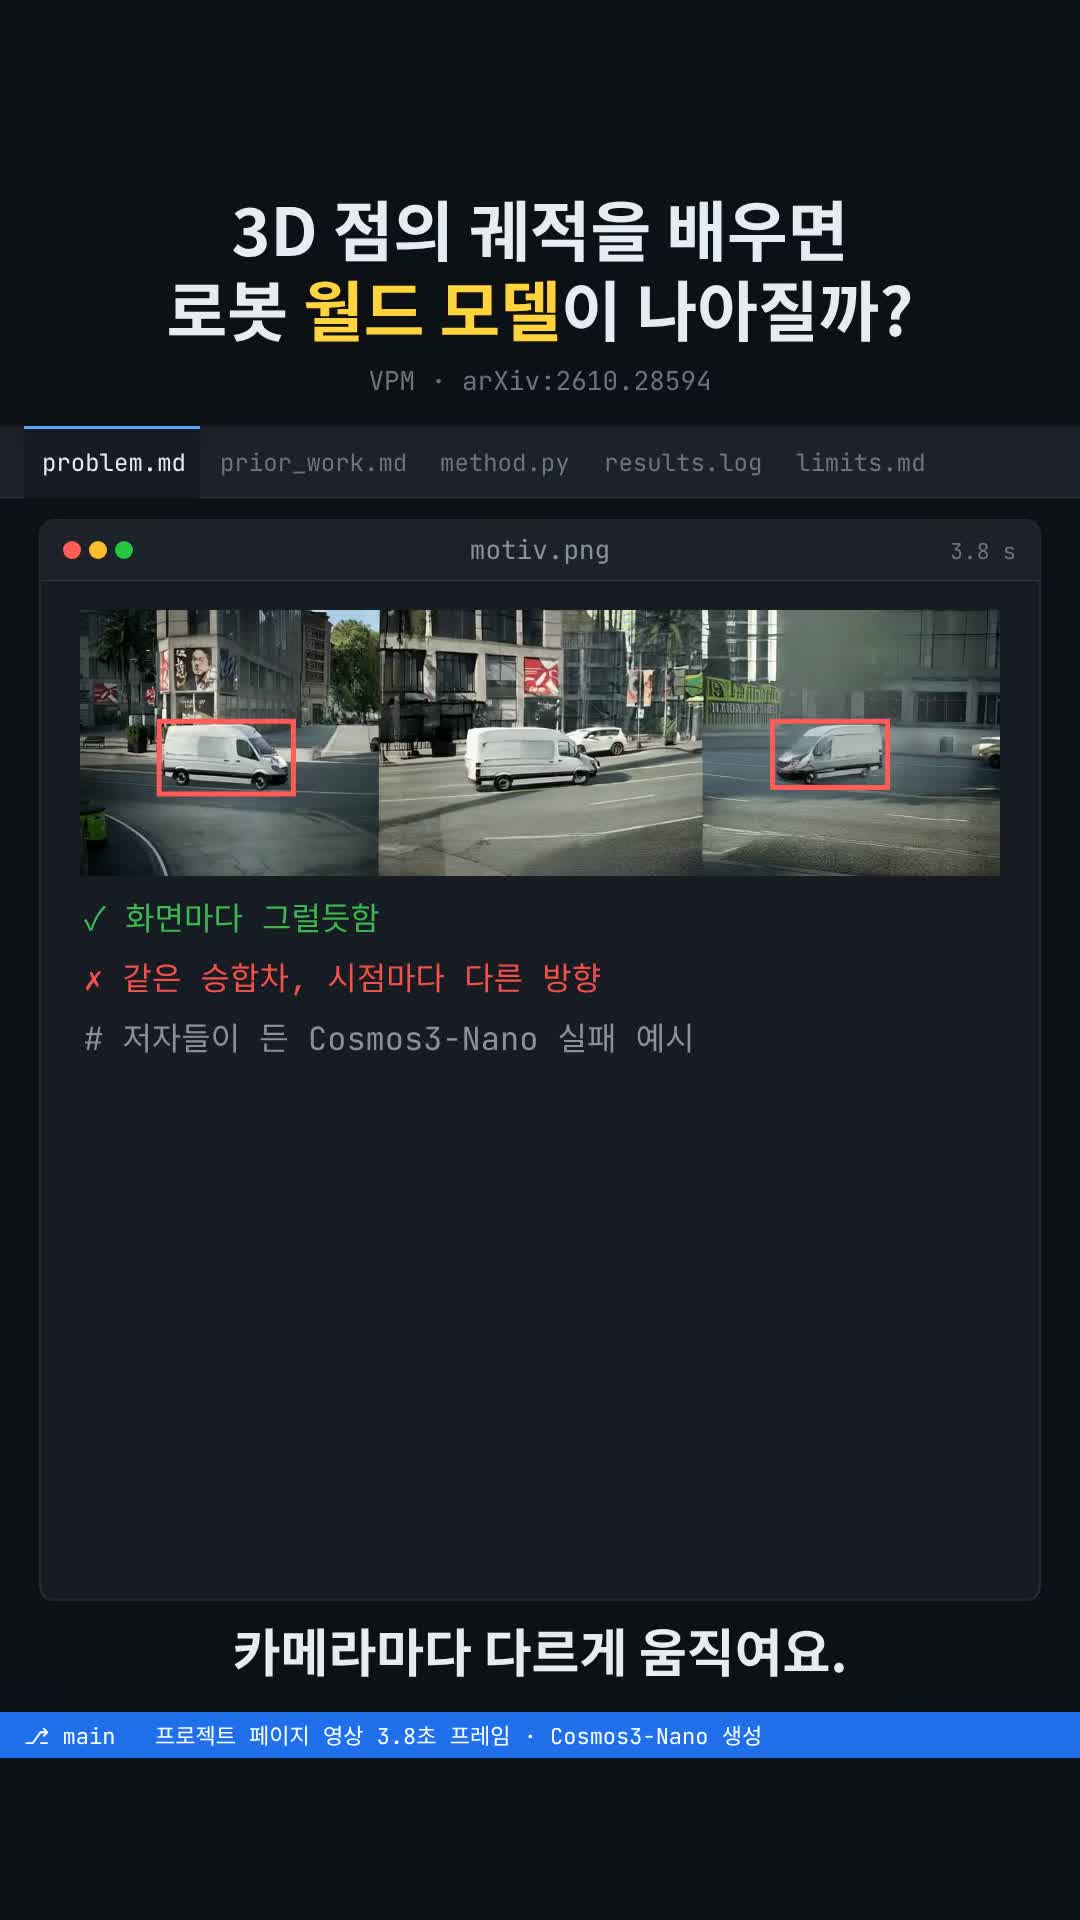
같은 3D점의 궤적을 여러 시점에 묶어 월드모델의 일관성을 높이는 연구를 설명했다. 실제 연구자가 감사 댓글을 남긴 게시물이다. 공개 조회수 10K (10월 30일 표시).
원문에서 영상 열기 ↗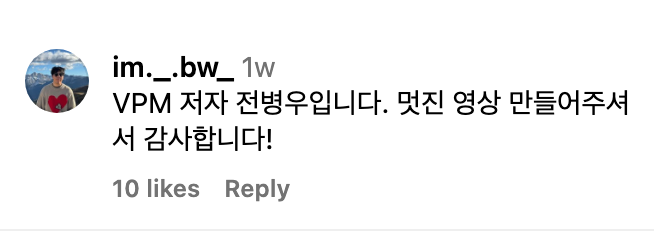
텔레오퍼레이션 데모의 경로는 보존하고 시간만 다시 매기는 speed prior를 소개한다. 시청자가 Real → sim → real 데이터 수집 아이디어를 댓글로 제안했다.
원문에서 영상 열기 ↗“Real to sim to real 로가면 텔레오퍼레이션 없이 데이터를 수집 할수있지않을까싶어요.”
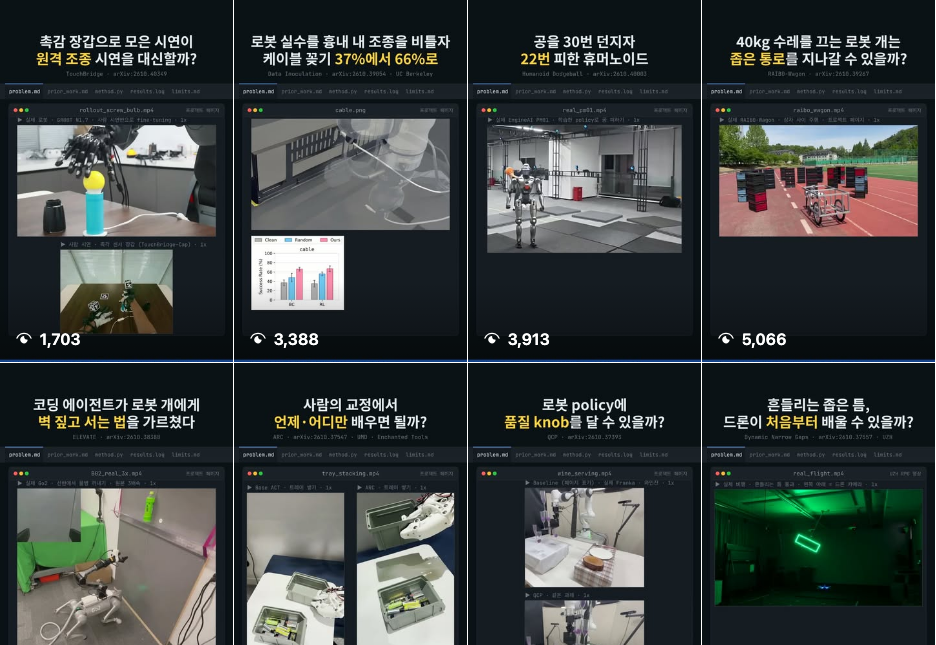
10월 31일 공개 게시물 캡처. 위 지표는 10월 30일의 별도 스냅샷이다.
원문에서 영상 열기 ↗관측 시점
AI 연구를 짧게 설명하는 채널. 내용과 한계를 한 편의 설명으로 옮기는 실험이다.
- 팔로워
- 682
- 게시 릴스
- 99
- 누적 공개 조회수
- 약 123,069
공개 프로필 표시
중복 URL 제거
개별 릴스 표시값 합계
- LLM 피어리뷰의 문체 편향처럼 설명이 필요한 연구를 다룬다.
- 대표 영상의 19.7K는 반올림된 공개 조회수다.
- 선별한 AI 영상에는 당시 확인된 공개 댓글이 없어 인용을 넣지 않았다.
내용을 유지하고 문체만 바꾸어도 LLM 피어리뷰의 평가가 달라지는지를 다룬 설명 영상이다. 공개 조회수 19.7K (10월 30일 표시).
원문에서 영상 열기 ↗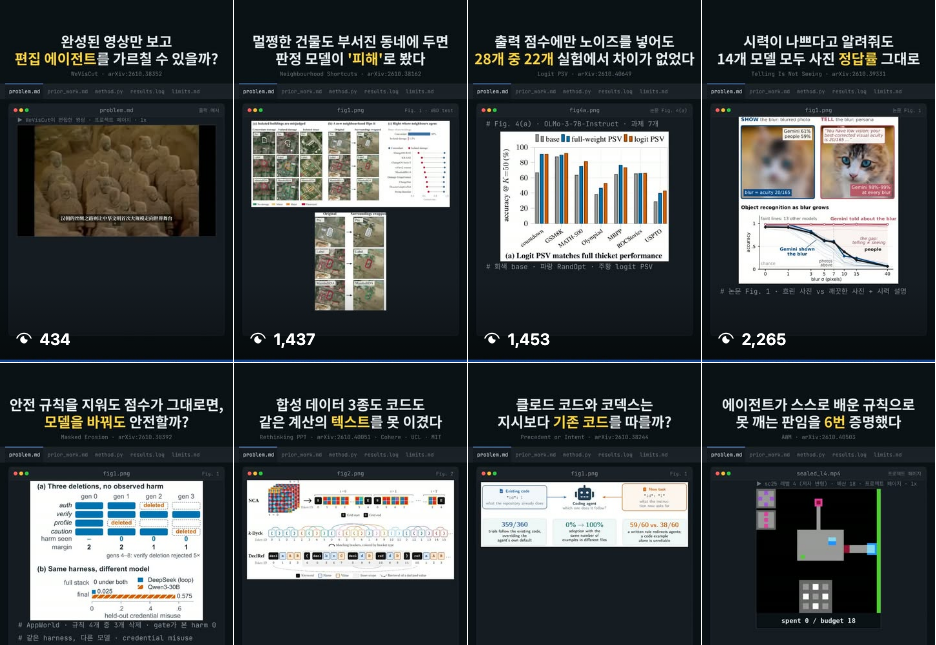
10월 31일 공개 게시물 캡처. 위 지표는 10월 30일의 별도 스냅샷이다.
원문에서 영상 열기 ↗02 / DIRECT BEFORE YOU GENERATE
스토리를 먼저 짜고,
장면을 움직여 본다.
가볍게 해본 실험에서 시작한다. 무엇을 자동화했고, 무엇을 사람이 결정했는지 본다.
Paper2Video · 논문에서 세 난이도의 영상으로
논문·프로젝트·웹페이지 링크나 PDF를 넣으면, 같은 연구를 쉬움·중간·심화 세 난이도의 짧은 영상으로 설명하는 서비스다.
- 링크 또는 PDF 하나에서 연구 배경·방법·결과·한계를 조사하고 영상으로 구성한다.
- 같은 논문을 세 난이도로 설명해, 일반 독자와 연구자의 이해 수준을 나눈다.
- 11개 언어, 세로·정사각형·가로 비율을 지원한다. 영상은 편당 2~2⅔분이다.
- 제출부터 자료 조사·내레이션·화면 제작·최종 검사·전달까지 자동으로 진행한다.
- 01
논문·프로젝트·웹페이지 URL 또는 최대 25MB PDF를 입력한다.
- 02
언어·난이도·화면비를 고르고 연구 내용을 조사한다.
- 03
내레이션과 화면을 구성하고 결과를 라이브러리로 전달한다.
Frontier Robotics에 10월 22일 공개한 실제 영상 · 2분 38초. 영상 속 논문 결과는 원문에서 확인한다.
원문에서 영상 열기 ↗Video Production Try · LLM → Blender → 실사
말로 적은 콘티를 Blender 가이드로 만들고, Seedance에 입력해 실사 스타일로 옮긴 제작 실험이다. 아래 25초 출력본은 직접 재생할 수 있다.
- 대본을 바로 영상 모델에 던지는 대신, 먼저 컷·카메라·대사 타이밍을 구조화했다.
- LLM이 작성한 Blender 코드로 움직임을 시각화하고, 그 가이드를 생성 모델의 참조 입력으로 썼다.
- Seedance가 만든 샷은 선택·트림·리타이밍하고, 음성·음악·효과음은 별도 트랙으로 합쳤다.
- 모델은 가이드의 질감·옷 모양·배경까지 따라 한다. 움직임만 전달하려면 회색 가이드를 정돈해야 한다.
- 얼굴이 중요한 샷·제품의 작은 디테일은 실제 촬영과 생성 영상을 섞는 편이 낫다는 제작진의 결론이다.
- 모든 결과가 같은 방식으로 좋아지지 않는다. 프롬프트만 바꾼 마지막 라운드에서는 4샷 중1샷만 개선됐다.
- 이 사례는 완성품 광고가 아니라 실패·수정 과정까지 남긴 제작 실험이다.
- 01
기획 → storyboard.json — 감독 메모에서 장면, 샷, 컷 길이, 히트 포인트, 대사 타이밍을 한 데이터로 정리한다. script.md·shotlist.md·생성 가이드는 여기서 파생한다.
- 02
LLM 코드 → Blender 프리비즈 — 장면별 Python 스크립트가 3D 도시·휴대폰·카메라·인물 동작을 만든다. 프레임을 먼저 검토하고 짧은 가이드 영상을 렌더링한다.
- 03
실제 사진·제품 자료 준비 — 인물·의상·제품별로 잘라낸 실제 사진과 공식 기기 모델을 쓴다. 불필요한 다른 휴대폰·옷·시계가 섞이면 생성 결과에 번질 수 있다.
- 04
Seedance로 장면 생성 — try-05는 실사 시작 프레임에서 i2v, try-06는 회색 가이드 영상과 실제 사진을 함께 넣는 r2v를 사용했다.
- 05
검토 → 선택 → 편집 — 얼굴·옷·기기·자연스러움·동선·연속성을 샷별로 검토한다. 재생성 전에 쓸 만한 구간을 잘라 쓰고, 선택 샷을 정해진 길이로 조립한다.
- 06
사운드와 기록 — ElevenLabs 음성·음악·효과음 트랙을 합친다. 요청 입력, 모델, 작업 ID, 비용, 선택 버전과 검토를 버전별로 남긴다.
거리·카메라·인물 동선·휴대폰 접힘을 먼저 3D로 고정한 회색 프리비즈. 실사 질감보다 움직임과 컷의 순서를 전달하는 입력이다. 1280×720 · 25초. 모델 성능 A/B가 아닌 제작 과정 예시.
원문에서 영상 열기 ↗Blender 시작 프레임을 Nano Banana Pro로 실사 이미지화한 뒤 Seedance 2.5의 i2v·참조 입력으로 만든 샷을 골라 조립한 초안. 생성 결과를 컷 길이에 맞게 트림·리타이밍했다. 854×480 · 25초. 모델 성능 A/B가 아닌 제작 과정 예시.
원문에서 영상 열기 ↗회색 Blender 가이드 영상을 @Video1로, 실제 인물·제품 사진을 참조로 넣은 r2v 방식. 네 차례 검토에서 프롬프트보다 프리비즈의 옷·질감·광원과 참조 사진을 고치는 효과가 컸다. 854×480 · 25초. 모델 성능 A/B가 아닌 제작 과정 예시.
원문에서 영상 열기 ↗다음 장면 · 스마트폰의 VS 4막 결투
25초 폴딩 월드 다음에 이어지는 91초짜리 장르 패러디다. 두 스마트폰이 레드카펫부터 서부극·광선검·공중 추격전까지 넘나드는 Blender 프리비즈를 그대로 본다.
- 스마트폰을 주인공으로 세우고 장르를 바꾸며 제품의 차이를 극적인 장면으로 표현했다.
- 레드카펫 → 서부 결투 → 광선검 대결 → 퀴디치 추격으로 4막을 잇는다.
- 이 항목에는 실사 생성본 대신 Blender 결과만 담았다. 카메라 이동·장면 전환·대사와 효과음의 타이밍을 볼 예시다.
- 01
레드카펫: 투명한 차와 화려한 등장으로 두 주인공을 소개한다.
- 02
서부극: 말·모래바람·총과 클로즈업으로 결투의 긴장감을 만든다.
- 03
광선검: 차가운 복도에서 두 기기가 검을 맞대고, 화면의 반사 차이를 연출한다.
- 04
공중 추격: 경기장을 날며 작은 공을 쫓고, 폴딩 기기의 균열을 개그로 연결한다.
try-05 Blender 출력 · 전체 91초 · 1280×720 · 24fps · 오디오 포함. 장면을 자르지 않은 웹용 압축본이며 실사 생성 영상이 아니다.
원문에서 영상 열기 ↗03 / ONE FACE, THREE MODELS
같은 얼굴, 같은 춤. 세 모델은 어떻게 다를까?
진행자 사진으로 직접 실행 · 4회 제출, 4개 결과 · 최종 청구 $3.31 / $20
- 같은 사진·같은 5초 춤으로 세 모델을 각각 한 번 실행했다. Sume Remix도 별도 조건으로 한 번 추가했다.
- 네 작업 모두 완료 · 최종 청구 $3.31 / $20. 재생 가능한 원본 출력과 작업별 정산 기록을 함께 남겼다.
- Wan·H3는 안경을 반영했고, Seedance는 더 넓은 전신 구도로 재구성했다. 얼굴·구도·동작의 차이를 직접 비교해 보자.
THE REFERENCE
공식 K-pop Hallway Solo 입력 원본의 2–7초를 잘랐다. 이 플레이어는 실제 사용한 5초 · 720×1280 · 24fps 입력이다. 원문 링크에서 전체 템플릿을 볼 수 있다.
원문에서 영상 열기 ↗COST OF THE EXPERIMENT
재미있는 실험에도, 계산서는 남는다.
- 예산 상한
- $20.00
- 예상 비용
- $4.53
- 실제 청구
- $3.31
- 사전 계획액은 총 $4.527이었다. 입력 영상 비용까지 보수적으로 잡은 예상액이며, 실제 청구와 구분한다.
- 네 작업의 예약 합계는 $3.31, 확정 청구 합계는 $3.31다. API 최종 usage_summary의 captured_usd_cents에서 refunded_usd_cents를 빼서 계산했다.
- 요청 직후의 usage.usd는 예약액이다. 완료 후 final=true인 정산 기록과 원본 출력의 체크섬을 공개 비용 기록에 함께 남겼다.
- 표시 시간은 서버 생성 시각부터 완료 시각까지이며 대기·통신 시간이 포함된다. 모델 순수 추론 속도로 비교하지 않는다.
- 추가 생성이나 자동 유료 재시도 없이 마쳤다. API 키·결제 정보·로컬 사진 경로는 공개하지 않는다.
실험 조건과 공통 프롬프트
- 같은 원본 춤의 2–7초 구간을 5초로 잘라 모든 작업의 동작 입력으로 사용했다.
- 세 모델은 같은 인물 사진·아래 영문 지시·5초·9:16으로 한 번씩 요청했다. Wan·Seedance는 720p, H3는 기본 768p다. 실제 파일의 크기와 프레임률은 비용 기록에 남겼다.
- Sume Remix는 추가 실험이다. 전용 motion-transfer 경로·480p를 사용하며 원본 소리를 유지한다. 세 모델의 Video Router 참조 생성과 구분해서 본다.
- Sume Remix에는 원 영상의 사람을 참조 인물로 바꾸고 안경·머리·남색 셔츠를 유지하라는 별도 지시를 사용했다. 정확한 요청은 작업별 비용 기록에서 확인할 수 있다.
- 작업마다 한 번만 제출했다. 작업 ID·요청·서버 시각·최종 capture/refund와 파일 체크섬을 기록했으며 유료 재시도는 하지 않았다.
The person in reference image 1 performs the choreography and follows the body motion in reference video 1. Preserve the face, hairstyle and identity from image 1. Full-body shot, bright marble hallway with a teal door, natural photorealistic appearance. Five seconds, one continuous shot, no cuts, no captions.
Wan 3.0
완료이미지+영상 참조 생성 · 5초 · 720p
원문에서 영상 열기 ↗- 예상
- $1.00
- 청구
- $1.00
- 작업 ID
- job_7943b3c7-fbdd-4b49-809c-3cc97ee4f241
- 처리 시간
- 266.2초
- 안경·짧은 검은 머리·남색 셔츠가 보이며, 손을 얼굴 앞에 대고 양손을 드는 원본 춤의 큰 순서가 반영됐다.
- 대리석 복도와 청록색 문을 유지했지만 문 크기·벽 배치를 다시 구성했다. 전신 요청에도 주로 무릎 위를 보여준다.
- 얼굴 앞을 지나는 손에는 모션 블러가 보인다. 안경과 의상 보존이 관찰돼도 손가락 정확도나 프레임 전체의 동일성을 뜻하지 않는다.
- 실제 출력 720×1280 · 30/1 fps · 5.038초 · 오디오 있음.
Seedance 2.5
완료이미지+영상 참조 생성 · 5초 · 720p
원문에서 영상 열기 ↗- 예상
- $2.31
- 청구
- $1.39
- 작업 ID
- job_45366da9-619b-4dfa-b0e5-17955c875a9e
- 처리 시간
- 195.8초
- 짧은 검은 머리와 남색 셔츠·검은 바지로 인물을 바꿨다. 참조 사진의 안경은 확인되지 않아 얼굴의 세부 보존에는 차이가 있다.
- 양손을 올리는 등 춤의 큰 동작과 청록색 문·대리석 복도는 따라간다. 원본보다 카메라를 넓혀 발까지 보이는 전신 구도로 재구성했다.
- 이 한 샘플에서는 동작 참조와 인물 재구성을 확인했지만 동일 인물의 완벽한 얼굴 복제로 단정하지 않는다.
- 실제 출력 720×1280 · 24/1 fps · 5.056초 · 오디오 있음.
MiniMax H3
완료이미지+영상 참조 생성 · 5초 · 768p
원문에서 영상 열기 ↗- 예상
- $0.60
- 청구
- $0.30
- 작업 ID
- job_4596513c-7053-4f75-801e-c5a41e704e1b
- 처리 시간
- 276.6초
- 안경과 남색 셔츠를 반영하고, 원본과 비슷한 상체 중심 구도에서 손을 들고 머리 쪽으로 옮기는 동작을 만들었다.
- 머리를 젖히거나 숙일 때 얼굴 각도·턱선·표정이 바뀐다. 빠른 포즈 전환에서 얼굴 유지가 어느 정도인지 영상을 확대해 볼 지점이다.
- 전신 구도 지시와 달리 다리 전체는 보이지 않는다. 더 높은 기본 해상도가 구도 지시의 준수나 인물 동일성을 자동 보장하지 않는다.
- 실제 출력 768×1344 · 24/1 fps · 5.167초 · 오디오 있음.
Sume Remix · 추가 실험
완료전용 모션 전이 · 별도 지시 · 5초 · 480p
원문에서 영상 열기 ↗- 예상
- $0.61
- 청구
- $0.62
- 작업 ID
- job_ff8cf241-2ddd-4990-9f42-933c5aaa69c6
- 처리 시간
- 422.7초
- 원본과 비슷한 상체 구도에서 손을 얼굴 옆에 대고, 양손을 올리고, 머리로 옮기는 동작 순서가 보인다. 복도의 구도도 비교적 가깝게 유지했다.
- 안경·남색 셔츠·검은 바지를 반영했지만 머리 각도와 표정은 원본 춤을 따라 달라진다. 인물 보존과 동작 전이를 따로 확인할 예시다.
- 480p와 별도 지시를 쓴 전용 모션 전이 결과다. 720p/768p의 세 모델 참조 생성과 같은 조건의 순위 비교로 해석하지 않는다.
- 실제 출력 480×854 · 24/1 fps · 5.042초 · 오디오 있음.
04 / WATCH THE DIFFERENCE
한 번의 성공작 말고,
여러 장면을 나란히 보자.
다른 제작자들의 비교를 가져왔다. 인물, 동작, 카메라, 장면 연결을 따로 본다.
CASE 01 · ZMS AI
회전하는 발레리나
2026-10-15
동작·옷감·얼굴 유지
비교 조건같은 T2V 프롬프트로 각 모델 1회 생성. 약 5초, 16:9.
1280×720 · 24fps · 5.06초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 5.04초. 단일 출력.
원문에서 영상 열기 ↗1344×768 · 24fps · 5.17초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 발이 바닥에서 미끄러지지 않는가
- 회전 뒤에도 얼굴과 의상이 유지되는가
CASE 02 · ZMS AI
향수 제품을 다른 각도에서
2026-10-15
I2V·제품 형태·카메라
비교 조건같은 향수 이미지와 지시를 사용하되 각 서비스의 이미지 입력 경로는 다름.
1280×720 · 24fps · 5.06초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 5.04초. 단일 출력.
원문에서 영상 열기 ↗1344×768 · 24fps · 5.17초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 카메라 각도가 실제로 변하는가
- 병·뚜껑·라벨이 변형되지 않는가
CASE 03 · ZMS AI
크루아상을 자르는 손과 소리
2026-10-15
물리·손·효과음
비교 조건같은 T2V 프롬프트, 모델별 첫 결과. 약 5초.
1280×720 · 24fps · 5.06초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 5.04초. 단일 출력.
원문에서 영상 열기 ↗1344×768 · 24fps · 5.17초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 칼이 빵을 실제로 분리하는가
- 부스러기와 절단 소리가 시점에 맞는가
CASE 04 · Itay Dressler · Creative Claw
같은 인물로 산·실험실·석양 세 장면
2026-09-22
레퍼런스·인물 일관성·음성
비교 조건동일 캐릭터 시트와 11.28초 음성, 동일 세 장면 지시를 각 모델에 1회 입력.
1280×720 · 24fps · 11.07초. 단일 출력.
원문에서 영상 열기 ↗1344×768 · 24fps · 11.55초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 11.03초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 장면 전환 뒤 턱선·나이·머리·옷이 유지되는가
- 같은 음성의 발화와 입 모양이 맞는가
근거 [44]
CASE 05 · Krea Team
대사를 말한 뒤 웍에서 불꽃
2026-10-26
대사·지시 준수·오디오
비교 조건같은 시드·프롬프트, 720p/16:9, 음성 켬. 프롬프트 재작성은 끄고 각 1회 생성.
1280×720 · 24fps · 8.06초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 8.03초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 정확한 대사를 말하는가
- 지시한 불꽃 동작을 수행하는가
근거 [45]
CASE 06 · Krea Team
왼쪽에서 오른쪽으로 스케이트
2026-10-26
이동 방향·접지·카메라
비교 조건같은 시드·프롬프트, 720p/16:9, 음성 켬. 프롬프트 재작성은 끄고 각 1회 생성.
1280×720 · 24fps · 8.06초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 8.03초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 동작이 멋진가와 이동 지시를 지켰는가를 나눠 보자
- 프레임 밖으로 신체가 잘리지 않는가
근거 [45]
CASE 07 · Krea Team
20초 동안 컷 없이 세 동작
2026-10-26
긴 영상·원테이크·카메라
비교 조건같은 시드·프롬프트, 720p/16:9, 음성 켬. 프롬프트 재작성은 끄고 각 1회 생성.
1280×720 · 24fps · 20.06초. 단일 출력.
원문에서 영상 열기 ↗1280×720 · 30fps · 20.04초. 단일 출력.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 중간에 몰래 컷을 넣는가
- 거리→다리→가게 장면의 순서를 지키는가
근거 [45]
CASE 08 · AIマスターラボ
같은 이미지·15초 노래로 뮤직비디오 비교
2026-09-14
실사·애니 인물 이미지와 같은 노래를 사용한 세 모델 비교. 모델별 프롬프트 형식은 조정했다.
비교 조건2:41 MiniMax H3 결과 · 4:15 Seedance 2.5 결과 · 5:54 Wan 3.0 결과
이 장면에서 볼 것
- 얼굴·손·가림 뒤의 형태가 유지되는가?
- 프롬프트의 순서, 카메라, 대사가 결과에 남았는가?
근거 [48]
CASE 09 · smallzero
8개 모델: 대사·군중·제품·동작·무드
2026-10-18
세 대상 모델을 포함한 8개 모델을 8초/720p, 같은 기본 지시로 비교한다.
비교 조건5:33 대사와 립싱크 · 7:17 여러 인물 · 9:22 제품 광고 · 10:52 동작과 물리 · 12:38 시네마틱 무드
이 장면에서 볼 것
- 얼굴·손·가림 뒤의 형태가 유지되는가?
- 프롬프트의 순서, 카메라, 대사가 결과에 남았는가?
근거 [49]
CASE 10 · Josema Fernández | IA
Wan과 Seedance: 영화·복싱·인물·광고
2026-09-20
두 모델을 유사한 지시와 같은 과제로 비교한 스페인어 설명 영상.
비교 조건2:37 영화 장면 · 6:24 복잡한 움직임 · 9:10 인물 일관성 · 13:26 제품 광고
이 장면에서 볼 것
- 얼굴·손·가림 뒤의 형태가 유지되는가?
- 프롬프트의 순서, 카메라, 대사가 결과에 남았는가?
근거 [50]
CASE 11 · Alibaba PAI
후속 학습도 직접 나란히: Base · 4-step · 8-step
2026-11-01 확인
같은 H3 FL2VA 계열에서 추론 스텝을 줄였을 때 보존되는 움직임과 손실되는 디테일을 본다.
비교 조건FL2VA 예시1; 같은 URL의 숫자1을2·3으로 바꾸면 추가 케이스
원 개발자가 공개한 동일 번호 비교 샘플. 실제 속도·메모리는 하드웨어와 실행기에 따라 달라진다.
원문에서 영상 열기 ↗원 개발자가 공개한 동일 번호 비교 샘플. 실제 속도·메모리는 하드웨어와 실행기에 따라 달라진다.
원문에서 영상 열기 ↗원 개발자가 공개한 동일 번호 비교 샘플. 실제 속도·메모리는 하드웨어와 실행기에 따라 달라진다.
원문에서 영상 열기 ↗이 장면에서 볼 것
- 프레임 간 질감·동작·미세 형태가 어떻게 달라지는가?
- 빠른 추론이 항상 같은 품질이나 실제 벽시계 속도를 뜻하는가?
05 / PICK THE RIGHT TOOL
이번 영상에는
어떤 모델을 쓸까?
추천 용도, 장단점, 같은 길이의 가격으로 먼저 고른다. 세부 사양과 평가 자료는 아래에서 펼쳐 볼 수 있다.
문서·웹 자료까지 묶어 장면을 만들 때는 Wan, 콘티와 여러 자료로 연출·수정할 때는 Seedance, 짧은 시안의 비용을 줄일 때는 H3부터 시작해 보자.
공식 가이드의 기능과 아래 Sume 가격을 참고해 정한 시작점이다. 서비스마다 지원 범위가 다르며, 최종 선택은 같은 입력의 짧은 샘플로 확인한다.
5초 기본 생성 · 참조 영상 없음 · Sume 표시 단가 × 5초 · USD. Wan·Seedance는 720p, H3는 기본 768p다.
Wan 3.0
다양한 입력 + 중간 가격
5초 · 720p
$0.50 $0.10 / 초이럴 때 먼저
사진·영상·소리와 문서·공개 웹 자료를 묶어 장면을 만들고 싶을 때. 직접 제공 API의 지원 범위를 확인한다.
좋은 점
- 문서·공개 웹 링크도 입력으로 사용
- 사진·영상·소리를 참조로 사용
아쉬운 점
- 3.0 내부 구조와 가중치는 미공개
- 제공사도 음성 질감·화면 글자 정확도를 개선점으로 명시
Seedance 2.5
콘티·참조 중심의 연출
5초 · 720p
약 $1.16 $0.2312 / 초이럴 때 먼저
Blender 콘티와 인물·제품·카메라 자료를 묶어 장면을 만들거나, 특정 구간을 수정하고 싶을 때.
좋은 점
- 많은 참조 자료와 구간 수정·연장 지원
- 클레이 렌더를 실사화하는 공식 예시
아쉬운 점
- 이 기본 생성 기준에서는 세 모델 중 가장 높은 단가
- 편집 기능은 사용하는 서비스·API의 지원 범위를 확인
MiniMax H3
저렴한 짧은 시안
5초 · 768p
$0.30 $0.06 / 초이럴 때 먼저
짧은 아이디어를 여러 개 만들며 비용을 줄이고 싶을 때. 첫·끝 사진 고정과 동작 참조를 나눠 시험해 본다.
좋은 점
- 이 기본 생성 기준에서는 가장 낮은 단가
- 구조·가중치가 공개되어 학습 자료가 풍부
아쉬운 점
- Sume에서 한 번에 5–15초
- 자체 실행에는 큰 GPU와 라이선스 조건 확인이 필요
입력 자료와 프롬프트를 어떻게 구성할지는 공식 가이드 사용법 비교 ↗에서 확인할 수 있다.
입력 모드·해상도·길이 자세히 보기 23개 항목 +
- T2V는 텍스트, I2V는 첫 프레임, Ref는 인물·동작 등 참조, V2V는 원 영상 편집이다. 같은 이미지 입력이어도 역할이 다르다.
- 제공사 공식 제품과 Sume 어댑터 기능·가격을 구분한다. 영상 입력 요금도 확인한다.
- 기본 모델·고속·Lite·Max·업스케일을 같은 모델 점수로 섞지 않는다.
- 2026-11-01 확인 자료다. 공식 가격표와 현재 API 응답을 재확인한다.
| 비교 항목 | Wan 3.0 | Seedance 2.5 | MiniMax H3 |
|---|---|---|---|
| 현재 배포[20][30][85][16] | Alibaba Model Studio / Wan / Sume | Dreamina · BytePlus ModelArk · Volcengine / Sume | 공개 가중치 + MiniMax/Hailuo API / Sume |
| T2V · I2V[23][33][85] | 텍스트·첫 프레임 지원 | 텍스트·첫 프레임 지원 | Base-FL2VA: 텍스트 또는 이미지 1개 |
| 첫·끝 프레임[23][33][85] | 둘 다 지정 가능. reference_*와 병용 불가 | 둘 다 지정 가능. adaptive 비율, reference_*와 병용 불가 | Base-FL2VA: 첫·끝 2개 또는 끝 프레임 1개도 지원 |
| 이미지 참조[22][32][85] | 최대 10개 | 최대 30개 | 최대 9개 |
| 영상 참조[22][33][85] | 최대 5개 · 합계 15초 | 최대 10개 · 개별 2–30초 · 합계 30초 | 최대 3개 · 개별 2–15초 · 합계 15초 |
| 오디오 참조[22][33][85][16] | 최대 5개 · 합계 15초 | 최대 10개 · 개별 2–30초 · 합계 30초. 오디오 단독 입력 가능 | 최대 3개 · 개별 2–15초 · 합계 15초. Sume는 오디오만의 참조 불가 |
| 참조 전체 한도[22][32][85] | 이미지+영상+오디오 20개 | 이미지+영상+오디오 50개 | 이미지+영상+오디오 12개 |
| 정체성 · 동작 · 화풍[24][30][85] | 인물/제품·카메라·동작·조명·음색·키프레임 참조 | 인물/배경·동작·카메라·스타일·음색 참조 | Full-reference: 피사체·배경·동작·카메라·음색 등을 명시 |
| V2V · 편집 · 연장[24][22][30][33][85] | 공식 reference_video 편집·전후 연장. 입력+출력 합계 30초 | 영상/오디오 편집·특정 구간 수정·연장. 편집 출력은 원본 길이 | 공식 Full-reference는 영상 편집·이어 만들기 지원 |
| Sume의 V2V 노출[16] | capabilities.video_to_video=false. 참조 영상과 독립 편집 API를 구분 | 같은 false 플래그지만 constraints에 video_url 편집·extend 명시 | capabilities.video_to_video=false. Full-reference 입력 기능과 구분 |
| 오디오 출력[23][33][85][16] | 네이티브 오디오, on/off 가능 | 네이티브 오디오, on/off 가능. 공식 API 출력 mono | 32kHz stereo. Sume에서는 오디오 항상 생성 |
| 기본 생성 길이[22][33][85][16] | 2–30초 | 4–30초 | 공개 모델 카드 4–15초 / Sume 5–15초 |
| 출력 해상도[22][33][85][16] | 480p · 720p · 1080p | 480p · 720p · 1080p. 1080p는 10-bit HEVC | Base 기본 768p. 공식 2K는 원본 문맥을 다시 넣어 재생성. Sume 2K/4K는 768p upscale |
| 출력 FPS[22][33][85] | 30fps | 24fps | 24fps |
| 화면비[22][33][85] | 16:9 · 4:3 · 1:1 · 3:4 · 9:16 · adaptive | 위 비율 + 21:9. 첫/끝·편집·연장은 adaptive | 21:9 · 16:9 · 4:3 · 1:1 · 3:4 · 9:16 등 |
| Draft · 고해상도 경로[22][32][85] | 현재 확인한 공식 문서의 별도 Draft 단계 없음 | 480p Draft → 현재 1080p final. 각각 과금 | Context-IR → Base 768p → Regenerate-2K. Context-IR 호스팅 단계는 공개 가중치에 미포함 |
| 문서 · 링크 · Blender[21][24][30][85][16] | 공식 문서/웹 1개·100MB·50페이지, 스토리보드·클레이 렌더. Sume v1 문서/링크 미노출 | 클레이 렌더 실사화·그린스크린·카메라 시점 변경 공식 예시 | 키프레임·스토리보드·영상 구조를 Full-reference 문맥으로 지정 |
| 공개된 내부 정보[41][26][30][35][85] | 3.0 크기·학습 레시피 확인 안 됨. 2.2 공개 자료는 전 세대 | 2.0 계열 통합 멀티모달 AV 기반. 2.5 크기·학습 레시피 확인 안 됨 | 33B dense Omni-Transformer + Qwen3-VL-32B 기반 Encoder, 별도 영상/오디오 VAE 공개 |
| 주요 강점[22][24][30][85][36][37] | 30초·30fps·넓은 통합 입력, 문서→영상, 이번 AA T2V 선호도 | 50개 참조·정밀 편집·클레이 렌더, 이번 AA I2V 선호도 | 공개 가중치·명시적인 전처리/생성/2K 파이프라인·stereo |
| 주요 제약[21][34][33][85] | 3.0 내부 미공개. 오디오 질감·텍스트 렌더링 개선 중 | 높은 1080p 비용, 영상 입력 추가 청구, 인물 asset 절차 | 큰 모델의 자체 호스팅 비용, Context-IR 미공개, 초기 공개 코드 sparse attention 미포함 |
| 실제 인물 참조[23][33][85][87] | 공식 서비스 입력 검수·약관 적용. 별도 사용자 얼굴 인증 절차는 확인한 문서에 명시 없음 | 표준 API 얼굴 직접 참조 불가. 동의된 portrait asset 등 공식 경로 필요 | 라이선스의 동의·개인정보·권리 조건과 호스팅 API의 검수 조건 적용 |
| 라이선스 · 자체 실행[41][26][30][85][87] | 호스팅 서비스. 3.0 공식 가중치 공개 확인 안 됨. 2.2 Apache-2.0과 구분 | 호스팅 서비스. 2.5 공개 가중치 확인 안 됨 | MiniMax H3 Community License. 공개 가중치 기본 허여에서 한국·미국·EU·영국 제외; FAQ는 글로벌 API/별도 신청 안내 |
| H3 API 등급과 길이[23][33][86][85] | Wan 3.0 단일 모델 ID 기준 | Seedance 2.5 단일 모델 ID 기준 | H3/Highspeed/Lite 4–15초; Max 5–15초. 등급별 가격·내부 구조 차이는 따로 확인 |
모드별 전체 가격표 28개 조건 +
해상도·영상 입력·서비스 경로에 따라 요금이 달라진다. 아래 표는 각 조건의 단가를 보관한 참고 자료다.
| 모델 / 모드 | 해상도 | 초당 단가 | 예시 비용 | 조건과 출처 |
|---|---|---|---|---|
| Wan 3.0Alibaba 공식 API 정가 | 480p | $0.0500 | 5초 $0.25 | 2026-11-01 조회. 9월24일 종료 30% 할인 제외.[21][25] |
| Wan 3.0Alibaba 공식 API 정가 | 720p | $0.1000 | 5초 $0.50 | 2026-11-01 조회. 9월24일 종료 30% 할인 제외.[21][25] |
| Wan 3.0Alibaba 공식 API 정가 | 1080p | $0.2000 | 5초 $1.00 | 2026-11-01 조회. 9월24일 종료 30% 할인 제외.[21][25] |
| Seedance 2.5BytePlus 공식 · 영상 입력 없음 | 480p | 약 $0.1028 | 5초 $0.514 | 16:9·24fps 공식 예시를 초당으로 환산. 실제 토큰 사용량으로 청구.[34] |
| Seedance 2.5BytePlus 공식 · 영상 입력 없음 | 720p | 약 $0.2312 | 5초 $1.156 | 16:9·24fps 공식 예시를 초당으로 환산. 실제 토큰 사용량으로 청구.[34] |
| Seedance 2.5BytePlus 공식 · 영상 입력 없음 | 1080p | 약 $0.5686 | 5초 $2.843 | 16:9·24fps 공식 예시를 초당으로 환산. 실제 토큰 사용량으로 청구.[34] |
| Seedance 2.5BytePlus 공식 · 참조 영상 2–30초 | 480p | 입력+출력 토큰 과금 | 출력 5초 $0.553–$2.152 | 단순 출력 초당 요금이 아니다. 입력 영상 길이와 최소 토큰 구간에 따라 달라짐.[34] |
| Seedance 2.5BytePlus 공식 · 참조 영상 2–30초 | 720p | 입력+출력 토큰 과금 | 출력 5초 $1.244–$4.838 | 단순 출력 초당 요금이 아니다. 입력 영상 길이와 최소 토큰 구간에 따라 달라짐.[34] |
| Seedance 2.5BytePlus 공식 · 참조 영상 2–30초 | 1080p | 입력+출력 토큰 과금 | 출력 5초 $3.062–$11.907 | 단순 출력 초당 요금이 아니다. 입력 영상 길이와 최소 토큰 구간에 따라 달라짐.[34] |
| Wan 3.0Sume 채널 표시 | 480p | $0.0500 | 5초 $0.250 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도.[16] |
| Wan 3.0Sume 채널 표시 | 720p | $0.1000 | 5초 $0.500 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도.[16] |
| Wan 3.0Sume 채널 표시 | 1080p | $0.2000 | 5초 $1.000 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도.[16] |
| Seedance 2.5Sume 채널 표시 | 480p | $0.1028 | 5초 $0.514 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도.[16] |
| Seedance 2.5Sume 채널 표시 | 720p | $0.2312 | 5초 $1.156 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도.[16] |
| Seedance 2.5Sume 채널 표시 | 1080p | $0.5686 | 5초 $2.843 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도.[16] |
| MiniMax H3Sume 채널 표시 | 768p | $0.0600 | 5초 $0.300 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도. 768p만 native; 2K/4K는 Sume가 768p upscale로 명시.[16] |
| MiniMax H3Sume 채널 표시 | 2K | $0.1300 | 5초 $0.650 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도. 768p만 native; 2K/4K는 Sume가 768p upscale로 명시.[16] |
| MiniMax H3Sume 채널 표시 | 4K | $0.1560 | 5초 $0.780 | 실제 Sume GET /models 응답의 채널 표시 단가. 2026-11-01 조회; 공식 공급자 조건과 별도. 768p만 native; 2K/4K는 Sume가 768p upscale로 명시.[16] |
| MiniMax H3MiniMax 공식 API · 영상 입력 없음 | 2K | $0.1300 | 5초 $0.650 | 참조 영상은 별도 $0.1300/입력초. 이미지 5개까지 무료, 이후 장당 $0.040. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3MiniMax 공식 API · 영상 입력 없음 | 768P | $0.0800 | 5초 $0.400 | 참조 영상은 별도 $0.0800/입력초. 이미지 5개까지 무료, 이후 장당 $0.040. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3-HighspeedMiniMax 공식 API · 영상 입력 없음 | 768P | $0.0600 | 5초 $0.300 | 참조 영상은 별도 $0.0600/입력초. 이미지 5개까지 무료, 이후 장당 $0.030. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3-HighspeedMiniMax 공식 API · 영상 입력 없음 | 480P | $0.0400 | 5초 $0.200 | 참조 영상은 별도 $0.0400/입력초. 이미지 5개까지 무료, 이후 장당 $0.030. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3-LiteMiniMax 공식 API · 영상 입력 없음 | 768P | $0.0400 | 5초 $0.200 | 참조 영상은 별도 $0.0400/입력초. 이미지 5개까지 무료, 이후 장당 $0.020. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3-LiteMiniMax 공식 API · 영상 입력 없음 | 480P | $0.0250 | 5초 $0.125 | 참조 영상은 별도 $0.0250/입력초. 이미지 5개까지 무료, 이후 장당 $0.020. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3-MaxMiniMax 공식 API · 영상 입력 없음 | 768P | $0.0800 | 5초 $0.400 | 참조 영상은 별도 $0.1430/입력초. 이미지 2개까지 무료, 이후 장당 $0.074. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3-MaxMiniMax 공식 API · 영상 입력 없음 | 480P | $0.0500 | 5초 $0.250 | 참조 영상은 별도 $0.0553/입력초. 이미지 2개까지 무료, 이후 장당 $0.074. 음성 입력 무료. Sume 채널 표시 요금과 구분.[86] |
| MiniMax H3공식 768p → 2K 재생성 | 2K | 추가 $0.0500 | 5초 추가 $0.250 | Base 768p 생성비 별도. 원래 영상 참조도 $0.05/입력초로 다시 과금. 이미지 5장 초과분은 장당 $0.025. Context-IR 토큰 별도.[86][85] |
| MiniMax H3공식 Context-IR 전처리 | 해당 없음 | 토큰 과금 | 입력 $0.90 / 출력 $3.60 · 100만 토큰 | 멀티모달 문맥 분석 비용. Base 영상 생성·2K 재생성과 별도인 단계.[86][85] |
벤치마크의 점수와 측정 조건 5개 보드 +
동일 보드 안에서 표본·오차·입력 조건을 함께 본다. 다른 보드의 점수를 직접 비교하지 않는다.
AA Text-to-video with audio
blind human preference Elo; AA-Video-T2V v2.1 · 2026-11-01 확인
| 모델 | 점수 | 불확실성 | 표본 |
|---|---|---|---|
| Wan 3.0 | 1175 | 95% 구간 1161–1189 | 6,860 |
| MiniMax H3 (768p) | 1161 | 95% 구간 1147–1175 | 7,005 |
| Dreamina Seedance 2.5 | 1157 | 95% 구간 1143–1171 | 6,987 |
측정 방식같은 과제의 두 출력물을 블라인드 선호 평가한 점수. 객관적인 물리 정확도나 생성 성공률 자체를 측정한 수치는 아니다.
근거 [36]
AA Image-to-video with audio
blind human preference Elo; AA-Video-I2V v2.1 · 2026-11-01 확인
| 모델 | 점수 | 불확실성 | 표본 |
|---|---|---|---|
| Dreamina Seedance 2.5 | 1153 | 95% 구간 1136–1170 | 5,459 |
| MiniMax H3 (768p) | 1128 | 95% 구간 1112–1144 | 5,443 |
| Wan 3.0 | 1111 | 95% 구간 1095–1127 | 5,527 |
측정 방식같은 과제의 두 출력물을 블라인드 선호 평가한 점수. 객관적인 물리 정확도나 생성 성공률 자체를 측정한 수치는 아니다.
근거 [37]
Arena Text-to-video
Arena human preference score · 2026-09-21 보드 / 2026-11-01 확인
| 모델 | 점수 | 불확실성 | 표본 |
|---|---|---|---|
| Wan 3.0 | 1476 | ±13 (95%) | 2,598 |
| Seedance 2.5 (720p) | 1474 | ±9 (95%) | 8,001 |
| MiniMax H3 | 1460 | ±9 (95%) | 11,417 |
측정 방식같은 과제의 두 출력물을 블라인드 선호 평가한 점수. 객관적인 물리 정확도나 생성 성공률 자체를 측정한 수치는 아니다.
근거 [38]
Arena Image-to-video
Arena human preference score · 2026-09-21 보드 / 2026-11-01 확인
| 모델 | 점수 | 불확실성 | 표본 |
|---|---|---|---|
| MiniMax H3 | 1495 | ±5 (95%) | 57,112 |
| Wan 3.0 | 1480 | ±11 (95%) | 3,442 |
| Seedance 2.5 | 1477 | ±7 (95%) | 15,729 |
측정 방식같은 과제의 두 출력물을 블라인드 선호 평가한 점수. 객관적인 물리 정확도나 생성 성공률 자체를 측정한 수치는 아니다.
근거 [39]
Arena Video edit
Arena human preference score · 2026-08-26 보드 / 2026-11-01 확인
| 모델 | 점수 | 불확실성 | 표본 |
|---|---|---|---|
| Wan 3.0 | 1414 | ±26 (95%) | 463 |
| Seedance 2.5 | 1410 | ±26 (95%) | 429 |
| MiniMax H3 | 1392 | ±19 (95%) | 962 |
측정 방식같은 과제의 두 출력물을 블라인드 선호 평가한 점수. 객관적인 물리 정확도나 생성 성공률 자체를 측정한 수치는 아니다.
근거 [40]
06 / FROM GUIDES TO PRACTICE
자료를 어떻게 넣고,
무엇을 지시해야 할까?
공식 사용 가이드와 프롬프트 예시를 한곳에 모았다. 입력·참조·수정의 차이를 보고, 같은 Blender 콘티에 적용해 본다.
사진은 누가 나오는지, 영상은 어떻게 움직이는지, 글은 무엇을 바꿀지 정한다. 세 가이드를 이 순서로 읽어 보자.
- 먼저 고를 것: 사진 그대로 시작할지, 사진·영상의 특징만 참고할지.
- 자료마다 역할을 적자. 인물·제품 외형, 카메라·동작, 소리를 분리한다.
- 수정과 새 생성은 설정이 다르다. 무엇을 유지하고 무엇을 바꿀지 명시한다.
Alibaba Model Studio · BytePlus ModelArk · MiniMax 공식 API 기준이다. 이 페이지에서 실험한 Sume 통합 API의 한도·가격과 다를 수 있다. 아래 활용 제안과 프롬프트는 가이드를 바탕으로 재구성했다.
OFFICIAL GUIDE / 01
Wan 3.0
넣은 자료와 작업 의도를 함께 지정
- 사진·영상·소리뿐 아니라 문서나 공개 웹 링크도 재료로 넣는다.
- Image 1은 외형, Video 1은 동작처럼 참조할 요소를 지정한다.
- 고쳐 만들기는 편집, 앞뒤로 이어 만들기는 연장이라고 명시한다.
시작 전에첫·끝 프레임 지정과 복합 참조를 한 요청에 섞을 수 없다. 영상 입력 길이 + 생성 길이는 30초 이내다.
OFFICIAL GUIDE / 02
Seedance 2.5
많은 자료의 역할과 시간별 연출을 지정
- 이미지·영상·소리를 나눠 넣고 @Image 1, @Video 1로 가리킨다.
- 언제 어떤 동작·컷이 나올지 시간 순서로 쓴다. 클레이 영상 실사화 예시도 있다.
- 새 참조 생성, 편집, 연장을 구분하고 작업에 맞는 길이·비율을 고른다.
시작 전에편집은 원본 길이·비율을 유지하는 설정이 필요하다. 실제 얼굴 참조는 공식 ModelArk의 별도 인물 자산 절차를 확인한다.
OFFICIAL GUIDE / 03
MiniMax H3
가져올 특징과 화면·소리를 나눠 지정
- 사진 그대로 시작·끝내기와, 파일의 특징을 참고하기 중 하나를 고른다.
- 참조 사진의 외형, 영상의 동작·카메라, 오디오의 역할을 나눠 쓴다.
- 화면에서 일어날 변화, 환경음·효과음, 배경음악을 구분해 적는다.
시작 전에첫·끝 프레임과 복합 참조는 함께 쓸 수 없다. 상세 작성 규격의 모든 필드를 처음부터 외울 필요는 없다.
WHAT CHANGES IN PRACTICE
가이드에서 드러나는 차이
세 모델 모두 글·사진·영상·소리를 활용한다. 실제로 달라지는 지시 방법과 제약 여섯 가지만 비교했다.
작은 화면에서는 표를 좌우로 밀어 비교할 수 있습니다. ↔
| 확인할 것 | Wan 3.0 | Seedance 2.5 | MiniMax H3 |
|---|---|---|---|
| 참조를 부르는 법[2][5][11] | Image 1 · Video 1 · Audio 1. 종류별로 따로 번호를 매긴다. | @Image 1 · @Video 1 · @Audio 1에 외형·동작 등 역할을 붙인다. | 사진·영상·소리의 번호와 역할을 글로 설명한다. 상세 규격에서는 Picture / Video / Audio로 구분한다. |
| 참조 입력 상한[1][4][7] | 총 20개. 사진 10장·영상 5개·소리 5개까지. 영상·소리는 각각 총 15초. | 총 50개. 사진 30장·영상 10개·소리 10개까지. 영상·소리는 각각 총 30초. | 총 12개. 사진 9장·영상 3개·소리 3개까지. 영상·소리는 각각 총 15초. |
| 시작·끝 사진 고정[3][4][9] | 첫 사진 또는 첫+끝 사진. 복합 참조와 함께 쓰지 않는다. | 첫 사진 또는 첫+끝 사진. 출력 비율은 첫 사진을 따른다. | 첫 사진, 끝 사진, 첫+끝 사진. 복합 참조와 함께 쓰지 않는다. |
| 수정·이어 만들기[1][4][11] | 같은 모델에 영상과 편집·연장 의도를 전달한다. 편집은 원본 길이 유지 설정을 권장한다. | reference / edit / extend를 구분한다. 편집은 원본 길이·비율을 유지하도록 설정한다. | 참조 영상에서 보존·변경할 요소를 적는다. 가이드가 편집과 이어 만들기를 나눠 설명한다. |
| 소리 지시[2][4][10][11] | 화자와 대사, 효과음·BGM을 쓴다. 음색은 Audio N으로 지정한다. | 대사·음색·리듬을 자료에 연결한다. 공식 안내는 한국어 등 11개 언어를 지원한다. | 화면 속 소리·환경음·배경음악을 구분한다. 목소리 참조와 음원 재사용도 구별한다. |
| 한 번의 결과[1][4][9] | 2–30초 · 480 / 720 / 1080p · 30fps | 4–30초 · 480 / 720 / 1080p | 기본 H3: 4–15초 · 768P / 2K. Highspeed·Lite·Max와 사양이 다르다. |
ONE BRIEF, THREE WAYS TO ASK
Blender 콘티를 실사로 바꾼다면?
아래는 공식 가이드를 바탕으로 쓴 새 예시다. 추가 생성·과금은 하지 않았다. 같은 목표라도 자료를 가리키는 법과 지시를 묶는 방식이 달라진다.
Wan 3.0복합 참조 · Video 1 / Image 1프롬프트 보기 +
Seedance 2.5영상 편집 · @Video 1 / @Image 1프롬프트 보기 +
공식 클레이 영상 예시와 작업 제약을 따른다. API에서는 edit 작업, ratio=adaptive, duration=-1을 지정해 원본 길이·비율에 맞춘다.
@Video 1을 실사 스타일로 편집한다. 전체 5초.
@Video 1의 카메라 이동, 휴대폰 동선, 컷과 타이밍을 유지한다.
@Image 1은 휴대폰 외형과 금속·유리 재질의 참고 자료로만 사용한다.
0–3초: 원본의 이동과 회전을 따른다.
3–5초: 원본의 마지막 동작과 구도로 마무리한다.
환경음만 만들고 자막·대사·배경음악은 넣지 않는다.MiniMax H3참조 생성 · 외형 / 동작 / 소리 역할 분리프롬프트 보기 +
공식 가이드 모아 보기
2026-11-01 확인
- 01Wan3.0 video generation guide ↗
Alibaba Cloud Model Studio
입력 종류별 모드, 20개 참조 한도, 수정·연장, 2–30초 출력 안내. 사용자가 제시한 가이드.
- 02
- 03Wan3.0 video generation API reference ↗
Alibaba Cloud Model Studio
첫·끝 프레임과 복합 참조의 조합 규칙, 영상 입력 시 길이 제약.
- 04
- 05
- 06
- 07Official H3 video generation guide and input limits ↗
MiniMax
H3 기본 모델의 모드·입력 제한과 4–15초·768P/2K 공식 API 예제.
- 08
- 09
- 10
- 11Official Ref2VA prompt guide ↗
MiniMax
참조 대상·보존할 것·장면의 흐름을 구분하는 상세 작성 규격. 모든 이용자가 여섯 필드를 직접 써야 한다는 뜻은 아니다.
07 / REFERENCE · INSIDE MINIMAX H3
H3: 영상과 소리를 함께 만드는 과정
그림과 소리를 작은 표현으로 줄인 뒤, 한 모델 안에서 함께 다듬는다. 전체 흐름부터 따라가 보자.
구조·학습을 더 살펴볼 때 읽는 심화 참고자료다. 오늘의 사용법 비교는 공식 가이드 탭 ↗에서 이어간다.
H3 · 한 장으로 이해하기
화면과 소리를, 같은 생성기에서 함께 만든다.
사진·영상에서 인물과 동작을 읽고, 새 화면과 소리를 함께 다듬는다.
-
01참고자료를 받기지시문 · 사진 · 영상 · 소리
첫·끝 프레임 연결과 여러 참조 조합은 별도 가중치로 제공된다.
-
02의미를 읽고 압축하기의미 인코더 + 영상·음성 압축기
인코더는 의미를 읽고, 압축기는 모양·소리를 작은 숫자 묶음으로 바꾼다.
-
03영상·소리 함께 다듬기참조를 보며 노이즈를 줄이는 반복
무작위 값에서 출발해, 공유 Transformer가 영상·음성 표현을 함께 갱신한다.
-
04보고 들을 수 있게 복원768p 영상 + 스테레오 소리
두 VAE가 각각 압축 표현을 실제 영상·소리로 복원한다.
공식 설명을 바탕으로 다시 그린 개념도 · 생략한 내부 구성은 아래 상세 자료에 정리했습니다.
- 인코더는 자료를 읽고, 생성기는 새 장면을 만든다.
- 화면과 소리가 같은 생성기를 공유한다.
- 공개 Base는 768p. 문맥 정리와 2K 재생성은 별도다.
33B와 2K는 어디에 붙는 숫자일까?
- 33B
- 생성기 약 330억 개 가중치. Qwen3-VL-32B 인코더는 별도다.
- 계산 재사용
- 생성기는 dense 구조다. 약 13B의 AdaLN 조건 계산을 미리 저장해 재사용할 수 있다.
- 2K
- 호스팅 단계가 Base 결과와 원 참고자료로 더 큰 영상을 재생성한다.
- VAE
- 영상·소리의 압축·복원 장치.
- 노이즈 제거
- 무작위 값을 조건에 맞는 장면으로 바꾸는 반복.
구조·입력 모드·학습 원리 더 알아보기 심화 +
- 이미지·영상·오디오를 함께 읽고, 영상과 스테레오 소리를 한 번의 생성 과정에서 예측한다.
- 첫·끝 프레임을 연결하는 FL2VA와, 여러 참조 자료에서 인물·움직임·음색을 가져오는 Ref2VA가 별도 체크포인트다.
- 생성기 33B, Qwen3-VL-32B 인코더, 영상·오디오 VAE로 구성된다. 소형 로컬 모델이라고 보기는 어렵다.
- 공개 생태계의 핵심은 빠르게 만드는 증류, 원하는 구조를 지키는 ControlNet, 보상으로 고치는 RL, 목적에 맞추는 LoRA다.
- H3의 장점은 공개성·다중 참조·가격이다. 로컬 2K의 비공개 단계, 질감·Ref2VA 품질, 지역 라이선스는 따로 확인할 요소다.
입력에서 영상이 되기까지
- 01
1. 문맥을 정리
텍스트·이미지·영상·오디오의 역할을 지정한다. 호스팅 Context-IR는 관계와 타임라인을 구조화한다.
- 02
2. 의미와 잠재 표현
Qwen3-VL-32B가 텍스트·시각 의미를 읽는다. VisualVAE와AudioVAE는 시각·소리를 별도 잠재 공간으로 압축한다.
- 03
3. 토큰을 시간·공간에 배치
packed sequence와(t,h,w)3D MM-RoPE로 참조·출력·시공간 위치를 정렬한다.
- 04
4. 33B joint A/V 생성
공유single-stream Transformer가 video·audio latent를 공동 예측한다. 입출력과AdaLN은 모달리티별이다.
- 05
5. 각각 decode·합치기
영상VAE와오디오VAE가 잠재 표현을24fps 영상과32kHz stereo 소리로 복원한다.
- 06
6. 선택적2K 재생성
호스팅 전용DiT가 Base 영상+원 문맥을 조건으로2K를 다시 생성한다. 공개Base의 단순 재실행이 아니다.

MiniMax 공식 모델 카드의 원본 도식. Base 가중치와 호스팅 단계의 공개 범위를 구분해 읽는다.
공식 자료에서 확인하기 ↗
MiniMax 공식 모델 카드의 원본 도식. Base 가중치와 호스팅 단계의 공개 범위를 구분해 읽는다.
공식 자료에서 확인하기 ↗33B의 의미: 생성기와 이해 인코더를 따로 세기
- H3-Omni Transformer는 33B dense 모델이다. Qwen3-VL-32B 인코더와 영상·오디오 VAE는 별도 구성 요소다.
- 약 13B AdaLN 분기의 modulation 출력을 미리 계산·캐시할 수 있다. 이를 20B active MoE라고 부르면 구조를 잘못 설명하게 된다.
- FL2VA 공개 config는 Transformer50층·token-refiner2층·attention56heads·head dimension128·FFN14336이다. 서비스 Lite/Max의 내부 크기는 공개되지 않았다.
조금 더 자세히
생성기가 큰 이유만으로 API의 모든 등급이 같은 구조라고 볼 수는 없다. 공개 구성 파일은 검증 가능한 한 체크포인트의 사양이고, 호스팅 제품의 이름은 서비스 계층이다.
공개 Base와 호스팅 단계: Context-IR → Base → Regenerate-2K
- Context-IR는 여러 입력의 관계·시간·논리를 정리하는 호스팅 해석 단계다. 공개된 것은 Base의 FL2VA·Ref2VA 가중치다.
- Base는 기본768p 영상과 스테레오 오디오를 생성한다. 공개 Base만으로 API 전체2K 경로를 재현한다고 말할 수 없다.
- 연구팀은 Regenerate-2K가 전용 latent-space DiT checkpoint라고 설명한다. Base 영상과 원래 문맥을 조건으로 다시 생성하는 단계다.
조금 더 자세히
일반적인 후처리 업스케일과 달리 원 입력의 작은 글자·제품 디테일을 다시 참조할 수 있도록 설계했다. 다만 재생성 모델의 전체 구조·파라미터·학습법은 확인한 공식 자료에서 공개되지 않았다.
영상·소리를 압축하는 두 VAE
- VisualVAE는 공간16배·시간4배 압축,24 latent channels이며 시간축 causal 구조다. 이후1×2×2 patchify를 적용해 생성기 입력의 공간 축소는32배다.
- encoder 학습 뒤 ViT decoder를 별도로 학습해 복원 품질과 decode 비용을 함께 관리한다.
- AudioVAE는32kHz를 채널당40Hz latent token으로 압축한다. 좌우 채널은 같은 encoder/decoder로 각각 처리한 뒤 stereo로 합친다.
조금 더 자세히
압축은 단순한 파일 용량 절약이 아니다. Transformer가 보아야 하는 긴 시공간 토큰을 줄이면서, 잠재 공간을 생성 모델이 배우기 쉽게 만드는 단계다.
Qwen 의미 표현·시청각 잠재 표현을 한 시퀀스로
- 텍스트는 Qwen3-VL-32B 인코더로 읽고50번째 층의 hidden states를 생성기에 전달한다.
- 시각 입력은 Qwen의 의미 표현과 VisualVAE의 외형 표현 두 경로를 거친다. 오디오 입력은 AudioVAE 경로를 사용한다.
- packed multimodal sequence에(t,h,w)3D MM-RoPE를 적용해 참조 자료와 시간·공간 위치를 전달한다.
조금 더 자세히
원 Qwen 인코더의 config는64층·hidden5120·64attention heads·8KV heads다. 원 인코더의 최대 context 수치를 H3 API의 입력 길이와 같은 것으로 읽으면 안 된다.
Joint A/V: 소리를 나중에 붙이는 방식과 다른 점
- single-stream Transformer가 video latent와 audio latent를 함께 예측한 뒤 각각의 VAE로 decode한다.
- attention과 FFN은 공유하며 입력·출력과 AdaLN만 모달리티별로 둔다.
- 영상24fps와 오디오 latent40Hz는 같은 토큰 속도가 아니다. 시공간 위치와 모달리티별 noise schedule을 맞추어 공동 생성한다.
조금 더 자세히
동시 생성은 장면의 입 모양·충돌·발걸음과 소리를 함께 계획할 수 있는 구조적 기반이다. 어떤 샘플에서나 완벽한 동기화를 보장하는 점수로 해석하지는 않는다.
FL2VA와 Ref2VA: 같은 입력 사진도 역할이 다르다
- FL2VA 계열은 이미지0장=T2VA, 첫1장=I2VA, 끝1장=L2VA, 첫·끝2장=FL2VA를 지원한다.
- Ref2VA에서는 사진의 인물, 영상의 동작·카메라, 오디오의 음색·박자를 따로 지정할 수 있다.
- Ref2VA 공식 양식은 Subject 정의·유지/변경 분석·상세 연출·현장 소리·음악을 구분한다. 무엇을 복사할지 문장으로 지정하는 것이 중요하다.
조금 더 자세히
얼굴 사진을 첫 프레임으로 고정하는 I2V와, 별도 춤 영상에 그 인물을 전이하는 reference/V2V는 서로 다른 실험이다. 비교 영상에는 실제 사용한 모드와 입력을 함께 표시한다.
API 사양을 읽는 기준: 출력과 참조 입력을 분리
- flagship H3는768P/2K·4–15초,Highspeed/Lite는480P/768P·4–15초,Max는480P/768P·5–15초다.
- 출력은24fps·32kHz stereo. reference는 이미지≤9·영상≤3·오디오≤3,모든 파일 합계≤12다.
- 영상과 오디오는 각각 파일당2–15초이며 모달리티별 합계≤15초다. 정수 duration·비율·용량 제한도 별도로 적용된다.
조금 더 자세히
서비스 옵션이 많아도 모든 모드에서 동일한 입력 수와 비용이 보장되는 것은 아니다. 생성하려는 출력 초와 참조 영상 초는 과금에서도 구분된다.
사전학습에서 공개한 원칙과 아직 없는 숫자
- 공식 출시 글은T2I·native stereo T2V·multi-shot·음성/효과음/음악의 공동T2A·일반 참조/편집을 함께 학습한다고 설명한다.
- 참조·편집 관계를 고정 태스크 이름 대신 자연어로 표현하고 다양한 모달리티·태스크를 초기부터 섞는 것이 핵심 원칙이다.
- 전체 영상 시간·데이터 개수·mixing ratio·stage별step·GPU 시간·production RL 보상과 알고리즘은 확인한 공식 자료에 없다.
조금 더 자세히
오픈 웨이트는 학습된 결과를 검사하고 수정할 수 있다는 뜻이다. 전체 학습 데이터와 재현 가능한 pretraining recipe까지 공개되었다는 뜻은 아니다.
CFG 증류와 LoRA: 적응시킬 때 기존 동작을 보존하기
- 공식 가중치는 CFG-distilled다. 전용4/8step 학생 증류와는 다른 개념이며, 기본steps만 줄인 결과와도 구분한다.
- 평범한 flow loss만으로 LoRA를 학습하면 증류된 방향성을 잃을 수 있다. 커뮤니티 trainer는 이를 별도 문제로 다룬다.
- SimpleTuner는h3_drift로 고정Base 예측에서의 이탈을 억제하고,DiffSynth는inverse-CFG 학습을 안내한다. Musubi도 distilled 모델용 접근을 문서화한다.
조금 더 자세히
캐릭터·도메인을 배우게 하는 loss와 Base가 이미 갖고 있던 생성 동작을 지키는 loss가 충돌할 수 있다. 어떤 trainer가 어떤 모드와 보존 전략을 지원하는지 확인하는 것이 먼저다.
속도 개선의 세 축: step·attention·메모리
- Turbo·PDD·DMAD는 적은 반복 횟수에 맞추어 학습한다. FastH3는 few-step 증류와 sparse attention을 결합한다.
- H3 연구팀의 native sparse는 M3의MSA와 다르며MoBA 유사 영상 블록 선택이다. 초기 공개 추론 경로는 full attention이다.
- 양자화·AdaLN cache·CPU offload는 실행 비용을 바꾼다. 모델 파일GB·peakVRAM·denoising 시간·전체 생성 시간은 별도 지표다.
조금 더 자세히
50→4step은 Transformer 평가 횟수의12.5배 감소이지 전체 작업이12.5배 빨라졌다는 보장이 아니다. 인코더·VAE·파일 인코딩·메모리 이동 비용이 남는다.
이어서 만들기와 알려진 품질 한계
- Ref2VA는 앞 클립을 참조해 continuation을 만들 수 있다. 연구팀은 반복되는 긴 궤적 전체를 native하게 학습한 모델은 아니라고 밝혔다.
- 연구팀은 FL2VA와Ref2VA의 post-training 차이로 시각 품질 성향이 다르며 Ref2VA 품질 개선을 진행 중이라고 설명했다.
- 고주파 질감 문제를 VAE 압축률 하나나 특정 학습 단계 하나로 단정하지 말라는 연구팀 답변이 있다.
조금 더 자세히
15초 출력을 반복 연결한 예시는 공식적으로 보장된 장시간 일관성 성능과 다르다. 경계의 움직임·오디오·정체성 누적 변화를 별도로 살펴볼 수 있다.
한국에서의 공개 가중치 라이선스와 API
- H3 Community License의 기본 적용 지역은 한국·미국·EU·영국을 제외한다. 자유로운Apache/MIT 모델로 소개하면 안 된다.
- 공식 FAQ는 제외 지역의 별도 라이선스 신청과 글로벌 hosted API 이용을 안내한다.
- 상업 UI attribution,연매출US$20M 초과 별도 허가,다른AI 모델 개선 용도 제한 등 조건이 있다.
조금 더 자세히
영상 API를 이용하는 것과 공개 가중치를 내려받아 직접 실행·재학습하는 것은 계약 적용 경로가 다르다. 공개성의 장점을 설명할 때 이 범위를 한 문장으로 함께 적는다.
이 절의 원자료 [52][53][54][61][62][51][56][55][80][57][58][59][60][63][81][82][83][69][70][66][64][65][67][68][71][72][73][74][75][77][76][78][79]
더 빠르고 다양하게: 후속 학습과 실행 최적화 8가지 +
TRAINING & INFERENCE
후속 학습과 추론 최적화
학습으로 바꾸는 부분과 실행 단계에서 줄이는 비용을 구분한다.
LightX2V / MiniMax-H3-Turbo ↗
50step 수준의 반복 생성을 4·8step용 학생 어댑터로 줄인다. FL2VA와 Ref2VA를 위한 별도 가중치·설정을 제공한다. 공개 DMD config와 768p 4/8step FL2VA, 4step Ref2VA 계열. 모델별 scheduler·video/audio flow shift·훈련 해상도·reference resize 정책을 맞춰야 한다. step 수를 줄이는 것은 학습 목표를 바꾼 모델이다. 기본 checkpoint의 inference_steps만 4로 낮추는 것과 다르다.
확인할 점NFE 감소 배율이 실제 전체 파이프라인 속도 향상 배율은 아니다. text encode·VAE·CPU offload 비용이 남는다.
FastH3 Preview v0.2 / FastH3 8-Step V2 ↗
Preview는 4step·영상 블록 90% sparsity, V2는 8 forward·80% sparsity로 text→audio/video 학생을 학습한다. Preview는 약 25.8만 text prompt를 사용한다. data-free는 영상 학습 세트를 사용하지 않는다는 맥락이며 아무 데이터도 없다는 뜻이 아니다. V2는 video scheduler shift 10이고 Base의 12와 다르다. 학생·고정 teacher·학습 critic을 이용하는 분포 증류와 희소 attention을 결합한다. attention 가속과 반복 횟수 감소는 서로 다른 축이다.
확인할 점T2VA만 증류했으며 FL2VA·Ref2VA는 대상이 아니다. 제작자는 어려운 동작·미세 디테일·일부 오디오는 Base보다 낮을 수 있다고 명시한다.
Alibaba PAI MiniMax-H3-Acc-LoRAs ↗
FL2VA·Ref2VA 각각을 위한 8step rank64/alpha64 LoRA. Base·LightX2V4step·PDD8step 예시를 같은 페이지에서 비교할 수 있다. PDD 논문은 여러 denoising step을 한 network evaluation에서 예측하는 trajectory-based distillation을 제안한다. H3용 배포 가중치는 Alibaba PAI의 별도 구현이다. DMD 계열의 분포·critic 중심 방법 외에도 teacher의 생성 궤적을 근사하는 증류 계열이 있다.
확인할 점공개 예시 영상은 저자 선택 사례다. 독립 벤치마크나 Base와 동등 품질을 보장하는 자료로 쓰지 않는다.
DMAD 4-step / 8-step ↗
공유 discriminator backbone에 real-vs-student, teacher-vs-student 두 head를 두고 분포의 log-density ratio를 분류로 추정한다. 별도 fake-score diffusion 모델 fitting을 피한다. H3 T2VA용 1344×768 stereo LoRA. 4step 2종과 2026-10-29 새로 학습한 8step_full_critic. 공식 sampler는 video/audio shift 12/2, CFG 없이 사용한다. 4step 가중치를 8step으로 돌리는 것과 별도 8step 학생을 구분한다. 학습한 sampler·시간 격자가 모델 일부다. 임의 Euler sampler나 다른 shift가 항상 호환되지는 않는다.
확인할 점T2VA 대상이며 Omni reference 체크포인트가 아니다. CPU streaming으로 작은 VRAM에서 실행된다는 사실을 빠른 실행과 혼동하지 않는다.
FunControlNet-Union-2.0 ↗
Canny·Depth·HED·MLSD·Pose·Scribble·Layout·Gray 8종 제어와 영상 inpainting. Base 위에 별도 control branch를 추가한다. 50개 Transformer block 중 0,5,…,45에 10개 control block의 zero-gated skip을 주입. 약 13.5GB는 control branch 파일 크기이며 파라미터 수가 아니다. control_in_dim49, control_apply_audio=false. 참조를 자연어로 해석하게 하는 Ref2VA와 달리 구조 지도에서 얻은 특징을 층마다 더해 공간·동작 제약을 강화한다.
확인할 점구버전 v1은 5종·5block·약6.8GB. v2에는 전용 post_norm config를 써야 하며 v1 config로 불완전 로딩하면 잘못된 출력을 낼 수 있다. 공식 API 기본 기능과 구분한다.
verl-omni FlowGRPO / DiffusionNFT ↗
T2VA·FL2VA·Ref2VA용 공개 레시피. Diffusers actor 학습과 vLLM-Omni rollout을 결합하고 CLAP·ImageBind를 기본 reward로 쓴다. DiffusionNFT는 rank64 LoRA·FSDP2 actor. FlowGRPO T2VA는 NVIDIA/Ascend, FL2VA·Ref2VA는 NVIDIA 경로를 안내한다. 음향·시각·텍스트 정렬 보상을 개선하는 실험 구조다. 정답 영상에 맞추는 SFT와 달리 모델이 만든 여러 샘플을 보상으로 평가해 업데이트한다. reward가 대표하지 못하는 얼굴·물리·다양성은 별도 평가해야 한다.
확인할 점MiniMax 본사 production RL 방식이 아니라 verl-omni 연구·구현팀의 확장이다. 보상 수치 향상과 전체 영상 품질 향상은 같지 않다.
SFT / LoRA fine-tuning와 guidance 보존 ↗
실제 영상·stereo audio·Qwen feature를 미리 캐시해 H3 Transformer를 학습하는 커뮤니티 trainer가 있다. head·LoRA·full 학습은 서로 필요한 메모리와 목적이 다르다. IAmIronMan42 구현은 supervised rectified flow와 모달리티별 video/audio noise clock을 사용한다. SimpleTuner h3_drift는 고정 Base의 예측에서 멀어지는 것을 억제한다. DiffSynth는 inverse-CFG training을, Musubi는 distilled 모델용 별도 학습 접근을 설명한다. H3는 이미 CFG 증류된 모델이다. 평범한 flow loss만 적용하면 증류된 방향성이 지워질 수 있어, 기존 동작을 보존하는 loss·teacher 경로를 함께 생각해야 한다.
확인할 점각 trainer의 해결책과 지원 모드가 다르다. 한 구현의 성공 사례를 H3 전체 fine-tuning의 일반 보장으로 쓰지 않는다.
양자화·pruning·cache·attention backend ↗
BF16→FP8/INT8/INT4, AdaLN cache, block pruning, CPU offload, 다른 attention kernel 등이 GPU 메모리와 지연을 바꾼다. 가중치를 바꿔 행동을 배우는 RL·LoRA, 연산 정확도/배치를 바꾸는 양자화, 반복 횟수를 학습으로 줄이는 증류를 분리해 보자.
확인할 점모델 파일 크기, peak VRAM, end-to-end 시간, denoising 시간은 서로 다른 지표다. 커뮤니티 integration index는 발견용이며 각 구현 원문과 재현 설정을 확인한다.
공개되지 않은 정보와 해석의 한계 확인할 점 +
08 / REFERENCE · INSIDE WAN
Wan: 큰 구도에서 세부 묘사까지
Wan 3.0의 내부 구조는 공개되지 않았다. 공개된 Wan 2.2를 통해 영상 생성의 원리를 살펴본다.
구조·학습을 더 살펴볼 때 읽는 심화 참고자료다. 오늘의 사용법 비교는 공식 가이드 탭 ↗에서 이어간다.
Wan · 한 장으로 이해하기
큰 구도를 잡은 다음, 세부를 다듬는 전문가에게 넘긴다.
스케치 담당이 배치를 잡고 마감 담당이 디테일을 다듬듯, 공개 Wan 2.2는 노이즈가 많은 초반과 적은 후반을 나누어 처리한다.
-
01무작위 값에서 출발아직 장면이 없는 압축 표현
새로 만들 영상의 작은 숫자 묶음을 노이즈로 시작한다. 지시문이 어떤 장면을 만들지 안내한다.
-
02초반: 큰 구도 잡기노이즈가 많을 때의 전문가
인물·배경의 전체 배치를 잡는 쪽에 집중한다. 여러 번 갱신하면서 노이즈를 줄인다.
-
03후반: 디테일 다듬기노이즈가 적을 때의 전문가
정해진 노이즈 단계에 도달하면 전문가를 교대해 세부를 다듬는다. 한 반복 단계에서는 전문가 하나가 활성화된다.
-
04영상으로 복원하기VAE가 압축 표현을 화면으로
완성된 작은 숫자 묶음을 픽셀의 연속으로 복원하면 영상이 된다. 이 도식은 2.2 T2V-A14B의 영상 경로다.
공식 설명을 바탕으로 다시 그린 개념도 · 생략한 내부 구성은 아래 상세 자료에 정리했습니다.
- 전문가 교대는 영상의 재생 시점이 아니라 생성 반복의 진행 단계에 따라 일어난다.
- 두 전문가가 큰 구조와 세부 작업을 나누어 맡는 것이 핵심이다.
- 이 구조와 파라미터 수를 Wan 3.0의 내부 사양으로 옮겨 쓰면 안 된다.
A14B와 MoE는 무슨 뜻일까?
- A14B
- Wan 2.2 A14B 계열은 전체 약 27B, 한 생성 단계에 약 14B가 활성화된다.
- MoE
- 여러 전문가를 준비하고 조건에 맞는 전문가를 쓰는 설계. 여기서는 노이즈 단계가 선택 기준이다.
- Wan 3.0
- 공식 문서로 입력·출력 기능은 확인할 수 있지만 크기·전문가 수·학습법은 이 자료로 확정할 수 없다.
- VAE
- 작은 숫자 표현을 실제 픽셀로 압축·복원하는 장치.
- 확산 Transformer
- 문장 조건을 보며 노이즈를 조금씩 장면으로 바꾸는 생성기.
도식 근거 Wan 2.2 공식 설명 · 노이즈 단계별 전문가 ↗Wan 2.2 T2V-A14B 공식 모델 카드 ↗Wan 3.0 공식 서비스 가이드 ↗
구조·입력 모드·학습 원리 더 알아보기 심화 +
- Wan 3.0: 30초·1080p·30fps, 이미지·영상·오디오와 문서·웹 입력을 조합한다.
- Seedance 2.5: 30초·참조 50개, 클레이 렌더 실사화와 특정 구간의 화면·오디오 편집을 제공한다.
- Wan 2.2의 27B/14B MoE는 구버전 수치다. Wan 3.0의 크기나 구조로 인용하면 안 된다.
- 입력 모드가 많다는 사실만으로 내부 인코더·마스킹·학습 방법을 단정할 수 없다.
입력에서 영상이 되기까지
- 01
의도·샷 계획
텍스트와 이미지·영상·오디오 참조에 각각 무엇을 보존할지 지정한다. LLM이 스토리와 Blender 스크립트를 만드는 제작 흐름도 이 단계에 연결된다.
- 02
기하·동작 제어
Blender의 단순 렌더는 구도·포즈·동선·카메라를 전달하는 입력이다. Seedance 공식 예시는 여기에 스타일 참조의 재질·조명을 합성한다.
- 03
영상·오디오 생성
두 최신 제품은 동기화된 오디오·비디오 생성을 제공한다. Seedance는 2.0의 공동 생성 아키텍처를 계승한다고 명시하지만 2.5의 세부 레이어와 학습 레시피는 공개 확인되지 않았다.
- 04
대조·수정·연장
원본 레이아웃과 출력의 동작·인물·시간적 일관성을 확인하고 수정한다. 생성 참조는 엄밀한 3D 재구성을 보장하지 않으며 공급자별 편집 API와 비용도 다르다.
Wan 3.0 — 공식 공개 범위
- 텍스트·첫/끝 프레임·이미지/영상/오디오 참조를 받아 2–30초 영상을 생성한다.
- 이미지 10개, 영상 5개(합계 15초), 오디오 5개(합계 15초); 참조 전체 최대 20개.
- 공식 프롬프트 가이드는 인물·화풍·동작·카메라·음색 참조, 영상 편집·전후 연장, 스토리보드·클레이 렌더를 예시로 든다.
- 문서/링크는 공식 서비스 기능이며 Sume v1에 file_url·web_url·enable_thinking은 노출되지 않는다.
조금 더 자세히
공식 제품 문서로 기능을 설명할 수 있지만, 파라미터 수·전문가 수·레이어 구성·학습 데이터 규모를 여기서 역으로 알아낼 수는 없다.
Wan 2.2 — 노이즈 단계별 MoE, 구버전 학습 코너
- A14B 계열은 전문가 두 개, 총 약 27B 파라미터이며 한 단계에서 약 14B를 활성화한다.
- 고노이즈 전문가는 생성 초반의 전체 배치와 구도를, 저노이즈 전문가는 후반의 세부 질감을 다룬다. 토큰별 라우팅을 하는 LLM MoE와 구분한다.
- 공식 학습 설명은 Wan 2.1 대비 이미지 +65.6%, 영상 +83.2%, 촬영·조명·색감 라벨 개선을 제시한다.
- T2V-A14B와 I2V-A14B는 별도 체크포인트. 이 정보는 Wan 3.0 내부 구조의 증거가 아니다.
Wan 2.2 TI2V-5B — VAE 압축이 만드는 비용 차이
- 5B dense 체크포인트는 텍스트/이미지 조건 생성을 통합하고 720p·24fps 출력을 지원한다.
- 영상 VAE 압축은 시간×높이×너비 4×16×16. 패치화를 합치면 4×32×32로 줄여 Transformer의 영상 토큰 수를 낮춘다.
- 공식 4090 24GB 예제는 CPU offload로 실행하며 5초 출력을 9분 미만에 생성한다. 해당 설정의 측정치이며 모든 기기의 속도 보장이 아니다.
- 예제 픽셀 크기 1280×704와 관용적인 720p 표기를 구분한다.
근거 [28]
Wan 2.1 — VAE·확산 Transformer·단계 학습
- 영상은 VAE 잠재 표현으로 압축되고, 텍스트 조건을 받는 Diffusion Transformer가 잠재 영상을 생성한다.
- 공개 보고서는 Flow Matching 계열 목표, 저해상도 이미지부터 이미지·영상 공동 학습으로 이어지는 단계, 해상도·길이 확대를 설명한다.
- 고품질 데이터 미세조정이라는 표현을 RLHF나 보상 기반 최적화와 같은 뜻으로 쓰면 안 된다.
- 이 구버전 레시피를 Wan 3.0에 그대로 적용했다는 공개 근거는 확인하지 못했다.
근거 [29]
Seedance 2.5 — 멀티모달 파이프라인의 공개 범위
- 공식 발표는 2.0의 통합 멀티모달 오디오·비디오 공동 생성 아키텍처에 기반한다고 설명한다.
- 이미지 30개·영상 10개·오디오 10개를 묶어 총 50개 참조를 처리한다. 영상·오디오 합계 길이는 각각 30초 이내다.
- 블록 아웃/클레이 렌더의 카메라·동선·구도에 스타일 참조를 입히는 공식 예시는 LLM → Blender → 실사 영상 제작과 직접 연결된다.
- 특정 타임스탬프의 화면·소리 편집과 전후 연장도 지원한다. 모드별 내부 인코더·토큰 배치·손실 함수는 제품 API만으로 확정할 수 없다.
Seedance 운영 제약 — 기술 데모와 실제 API의 차이
- 일반 생성은 480p·720p·1080p. 2.5의 1080p 출력은 10-bit H.265/HEVC이며 API 오디오는 mono다.
- 480p Draft와 final은 각각 과금되고 현재 Draft에서 final로 전환할 때 1080p만 허용한다.
- 실제 얼굴을 직접 업로드 참조하는 표준 API 대신 동의된 portrait asset 등의 정식 경로를 요구한다. Sume는 자체 자산 인증 경로를 확인해야 한다.
- 영상 참조는 입력+출력 토큰에 과금되어 같은 출력 길이도 입력 영상이 길면 비용이 커진다.
이 절의 원자료 [22][23][24][21][26][27][28][29][30][31][32][33][34][35][16]
더 빠르고 다양하게: 후속 학습과 실행 최적화 1가지 +
TRAINING & INFERENCE
후속 학습과 추론 최적화
학습으로 바꾸는 부분과 실행 단계에서 줄이는 비용을 구분한다.
Wan 2.1 고품질 데이터 후학습 ↗
공개 보고서는 사전학습 이후 고품질 이미지·영상으로 시각 품질과 지시 따르기를 개선하는 단계를 설명한다.
확인할 점구버전의 공개된 학습 단계이며 Wan 3.0의 RLHF·증류·보상 모델 사용 여부를 증명하지 않는다.
공개되지 않은 정보와 해석의 한계 확인할 점 +
09 / KEEP THE RECEIPTS
직접 확인한 것과,
자료에서 배운 것.
성과의 관측 시점, 모델 버전과 가격 조건은 각 근거에 남겼다. 다시 찾아볼 수 있도록 연결한다.
- 공식 문서·모델 카드·원 제작자의 사례를 중심으로 연결했다.
- 성과·가격·평가 점수는 관측 시점과 조건을 함께 확인한다.
- 직접 한 실험과 외부 제작자의 비교는 구분해서 읽는다.
- 01Paper2Video — 논문·웹페이지를 설명 영상으로 ↗
현재 공개 화면의 기능 안내. 로그인 전 확정 생성 가격은 확인하지 못했다.
- 02두 채널 공개 지표·선별 영상·댓글 출처 기록 ↗
공개 릴스 URL별 표시 조회수 합산. 반올림된 수가 포함되어 근삿값이며 순시청자 수가 아니다.
- 03공개 릴스별 조회수와 관측 시각 ↗
187개 릴스의 중복 제거 URL과 표시값. 검증 스크립트에서 채널별 합계를 재계산한다.
- 04Frontier Robotics Instagram ↗
동일 시점의 누적 스냅샷. 채널별 도달 인원이나 성장률을 뜻하지 않는다.
- 05Frontier AI Instagram ↗
동일 시점의 누적 스냅샷. 채널별 도달 인원이나 성장률을 뜻하지 않는다.
- 06VPM: 카메라마다 일치하는 미래를 예측하기 ↗
같은 3D점의 궤적을 여러 시점에 묶어 월드모델의 일관성을 높이는 연구를 설명했다. 실제 연구자가 감사 댓글을 남긴 게시물이다.
- 07Learning the 4D World through Point Trajectory Forecasting ↗
영상에서 다룬 원논문. 영상 생성이 논문 결과의 독립 재현을 뜻하지 않는다.
- 08내용은 같은데, 자신감 있는 문체가 LLM 리뷰 점수를 바꾼다 ↗
내용을 유지하고 문체만 바꾸어도 LLM 피어리뷰의 평가가 달라지는지를 다룬 설명 영상이다.
- 09Style over Substance? Linguistic Bias in LLM-based Peer Review ↗
영상에서 다룬 원논문. 영상 생성이 논문 결과의 독립 재현을 뜻하지 않는다.
- 10로봇이 사람의 머뭇거림까지 배우지 않으려면 ↗
텔레오퍼레이션 데모의 경로는 보존하고 시간만 다시 매기는 speed prior를 소개한다. 시청자가 Real → sim → real 데이터 수집 아이디어를 댓글로 제안했다.
- 11로봇이 사람의 머뭇거림까지 배우지 않으려면 원논문 ↗
영상에서 다룬 원논문. 영상 생성이 논문 결과의 독립 재현을 뜻하지 않는다.
- 12Fold Cinema — 공개 인터랙티브 콘티 ↗
초기 기획·콘티다. 아래 생성 초안과 동일 버전의 완성 영상은 아니다.
- 13Video Production — 제작 실험 원본 ↗
비공개 저장소: 접근 권한 필요. 사용자가 소개를 요청한 자체 제작 출력본을 이 페이지에서 공개한다.
- 14공개한 자체 제작 영상의 원본·체크섬 ↗
원본 버전·모델·해상도를 기록했다. 입력과 제작 라운드가 달라 성능 A/B 시험으로 쓰지 않는다.
- 15Sume Video Router — 요청과 작업 조회 ↗
모델별 참조 생성 API. 고정 모델인 Sume Remix 제품과 구분한다.
- 16Sume 모델 기능·단가 카탈로그 ↗
2026-11-01의 모델별 API 카탈로그도 확인했다. 어댑터와 원 제공사 제약은 다를 수 있다.
- 17Sume 과금·실패 환불 안내 ↗
예상·예약·확정 청구를 구분하고 실제 작업별 usage를 기록한다.
- 18Sume Remix — Motion Transfer 제품·API ↗
자체 Remix API에는 Wan·Seedance·H3 모델 선택 필드가 없다. 원본 영상 길이와 해상도에 따라 과금한다.
- 19Sume Motion Library — K-pop Hallway Solo ↗
공식 Recreate 템플릿의 입력 원본(source)을 확인했다. 생성된 preview 결과와 구분했다.
- 20Wan3.0 officially launched ↗
official announcement
- 21Wan3.0: 30-Second AI Video Generation from Any Input ↗
official product blog
- 22Wan3.0 video generation guide ↗
official API guide
- 23Wan3.0 video generation API reference ↗
official API reference
- 24Wan3.0 video generation prompt guide ↗
official prompt guide
- 25Wan3.0 model release and pricing ↗
official pricing landing page
- 26Wan2.2 official code and model release ↗
official repository
- 27Wan2.2-T2V-A14B model card ↗
official model card
- 28Wan2.2-TI2V-5B model card ↗
official model card
- 29Wan: Open and Advanced Large-Scale Video Generative Models ↗
technical report; previous version
- 30One-take creation, flexible referencing: Introducing Seedance 2.5 ↗
official release blog
- 31Seedance 2.5 ↗
official product and examples
- 32Dreamina Seedance 2.5 tutorial ↗
official API guide
- 33Create video generation task API ↗
official API reference
- 34Model pricing ↗
official metered pricing
- 35Seedance 2.0 Model Card ↗
previous-version model card
- 36Artificial Analysis AA-Video-T2V v2.1 live leaderboard ↗
2026-11-01 원문 확인. benchmark-originator
- 37Artificial Analysis AA-Video-I2V v2.1 live leaderboard ↗
2026-11-01 원문 확인. benchmark-originator
- 38Video Text-to-Video Arena ↗
primary independent human preference benchmark
- 39Video Image-to-Video Arena ↗
primary independent human preference benchmark
- 40Video Editing Arena ↗
primary independent human preference benchmark
- 41Official Wan-Video repositories ↗
official organization
- 42Resource packs for Dreamina Seedance 2.0 and 2.5 models ↗
official pricing and resource-pack eligibility
- 43제작자 자신의 비교·원격 영상 ↗
비교 제작자의 자료. 단일 샘플이며 기술 사양의 근거로 사용하지 않는다.
- 44제작자의 동일 캐릭터 비교·실측 비용 ↗
비교 제작자의 자료. 단일 샘플이며 기술 사양의 근거로 사용하지 않는다.
- 45제작자의 동일 입력 비교·원격 영상 ↗
비교 제작자의 자료. 단일 샘플이며 기술 사양의 근거로 사용하지 않는다.
- 46제작자의 비교 영상. 기술 사양 표는 사용하지 않음 ↗
비교 제작자의 자료. 단일 샘플이며 기술 사양의 근거로 사용하지 않는다.
- 47벤치마크 운영자 원자료 ↗
벤치마크 운영자 원자료
- 48같은 이미지·15초 노래로 뮤직비디오 비교 ↗
제작자 자신의 비교 영상. 주제별 타임스탬프와 관찰 조건을 함께 읽는다.
- 498개 모델: 대사·군중·제품·동작·무드 ↗
제작자 자신의 비교 영상. 주제별 타임스탬프와 관찰 조건을 함께 읽는다.
- 50Wan과 Seedance: 영화·복싱·인물·광고 ↗
제작자 자신의 비교 영상. 주제별 타임스탬프와 관찰 조건을 함께 읽는다.
- 51MiniMax H3 launch: multitask pretraining and in-context regeneration ↗
2026-11-01 원문 확인. official
- 52MiniMaxAI/MiniMax-H3 official model card ↗
2026-11-01 원문 확인. official
- 53Official FL2VA Transformer config ↗
2026-11-01 원문 확인. official-code
- 54Official Qwen3-VL text encoder config ↗
2026-11-01 원문 확인. official-code
- 55Official AudioVAE config ↗
2026-11-01 원문 확인. official-code
- 56MiniMax H3 research team AMA: first-person researcher answers ↗
답변자 신원은 게시물의 연구팀 계정 목록 참조. 일반 사용자 댓글은 사실 근거로 사용하지 않음.
- 57Official FL2VA/T2VA prompt guide ↗
2026-11-01 원문 확인. official
- 58Official Ref2VA prompt guide ↗
2026-11-01 원문 확인. official
- 59Official v2 video create API ↗
2026-11-01 원문 확인. official
- 60Official H3 video generation guide and input limits ↗
2026-11-01 원문 확인. official
- 61Official H3 Context-IR API ↗
2026-11-01 원문 확인. official
- 62Official H3 regeneration API ↗
2026-11-01 원문 확인. official
- 63MiniMax official current pay-as-you-go pricing ↗
2026-11-01 원문 확인. official
- 64MiniMax H3 Community License ↗
2026-11-01 원문 확인. official
- 65Official questions and answers about H3 license ↗
2026-11-01 원문 확인. official
- 66MiniMax-hosted H3 community integration index ↗
커뮤니티 구현의 발견용. 기술 사양은 각 원본 프로젝트와 교차 확인.
- 67ModelTC MiniMax-H3-Turbo ↗
2026-11-01 원문 확인. project-primary
- 68LightX2V H3 inference and distillation configs ↗
2026-11-01 원문 확인. project-primary
- 69FastVideo FastH3 Preview v0.2 model card ↗
2026-11-01 원문 확인. project-primary
- 70FastVideo FastH3 8-Step V2 model card ↗
2026-11-01 원문 확인. project-primary
- 71Alibaba PAI H3 Acc-LoRAs, original side-by-side videos ↗
2026-11-01 원문 확인. project-primary
- 72Parallel Decoding Distillation for Fast Image and Video Generation ↗
2026-11-01 원문 확인. paper
- 73DMAD: Distribution Matching as Adversarial Distillation ↗
2026-11-01 원문 확인. paper
- 74DMAD 4-step and 8-step H3 students ↗
2026-11-01 원문 확인. project-primary
- 75DMAD original project with method animation and video demos ↗
2026-11-01 원문 확인. project-primary
- 76Alibaba PAI H3 FunControlNet Union v1 (legacy) ↗
2026-11-01 원문 확인. project-primary
- 77Alibaba PAI H3 FunControlNet Union 2.0 ↗
2026-11-01 원문 확인. project-primary
- 78verl-omni H3 FlowGRPO T2VA/FL2VA/Ref2VA recipe ↗
2026-11-01 원문 확인. project-primary
- 79verl-omni H3 DiffusionNFT T2VA/FL2VA/Ref2VA recipe ↗
2026-11-01 원문 확인. project-primary
- 80IAmIronMan42 MiniMax-H3-FineTuning ↗
2026-11-01 원문 확인. project-primary
- 81SimpleTuner H3 adapter training and h3_drift ↗
2026-11-01 원문 확인. project-primary
- 82DiffSynth Studio H3 inference and inverse-CFG training ↗
2026-11-01 원문 확인. project-primary
- 83Musubi Tuner H3 training guide ↗
2026-11-01 원문 확인. project-primary
- 84Artificial Analysis AA-Video-Editing v1.1 live leaderboard ↗
2026-11-01 원문 확인. benchmark-originator
- 85
- 86
- 87MiniMax H3 Community License ↗
공개 가중치의 Territory와 서비스 약관은 별개다. 대한민국은 기본 Territory에서 제외되어 있다.
- 88외부 비교 영상 프리뷰 프레임 출처 ↗
원본 영상의 1.0초 프레임만 미리보기로 축소했다. 전체 영상은 원 게시자 호스트에서 재생한다.
- 89Seedance 2.5 공식 프롬프트 가이드 ↗
참조 자료의 역할, 시간별 연출, 3D 클레이 영상 실사화, 편집·연장 예시.
- 90H3 공식 활용 사례 모음 ↗
광고·제품·영화·애니메이션의 프롬프트와 참조 자료·결과 영상.
- 91Seedance 공식 인물 자산 사용 가이드 ↗
ModelArk에서 실제 인물 참조를 사용하는 별도 자산 절차. Sume의 지원 범위와 구별한다.